
Advanced CNN
GoogLeNet
减少代码的冗余:过程式函数;面向对象类
**Inception
Inception Module:
**引入:实际情况下我们不知道Kernel_size选择哪一个比较好用 因而我们在Googlenet的Inception Module块中我们都用一下 然后将几种卷积的结果摞在一起
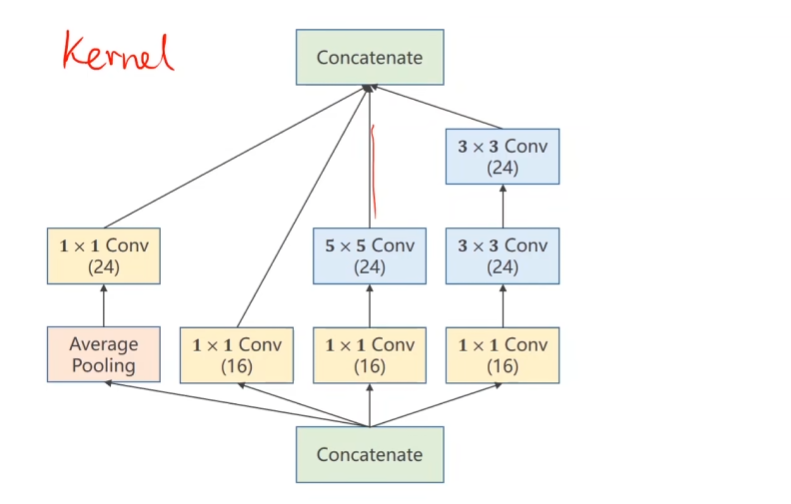
**Concatenate:沿着通道Channel拼接 对于pooling和conv都可以通过padding保证size的不变
Whats 1*1 Conv:
可以改变Channel的数量
Implementation of Inception Module:
- **Average Pooling+1*1conv:
self.branch_pool=nn.Conv2d(in_channels,24,kernel_size=1)

branch_pool=F.avg_pool2d(x,kernel_size=2,stride=1,padding=1)
branch_poll=self.branch_pool(branch_pool)- **1*1Conv:
self.branch1x1=nn.Conv2d(in_channels,16,kernel_size=1)
branch1x1=self.branch1x1(x)- **11Conv+55Conv:
self.branch5x5_1=nn.Conv2d(in_channels,16,kernel_size=1)
self.branch5x5_2=nn.Conv2d(16,24,kernel_size=5,padding=2)

branch5x5=self.branch5x5_1(x)
branch5x5=self.branch5x5_2(branch5x5)- **11Conv+33Conv+3*3Conv:
self.branch3x3_1=nn.Conv2d(in_channels,16,kernel_size=1)
self.branch3x3_2=nn.Conv2d(16,24,kernel_size=3,padding_size=1)
self.branch3x3_3=nn.Conv2d(24,24,kernel_size=3,padding_size=1)

branch3x3=self.branch3x3_1(x)
branch3x3=self.branch3x3_2(branch3x3)- **Concatenate:
outputs=[branch1x1,branch5x5,branch3x3,branch_pool]
return torch.cal(outputs,dim=1)
class InceptionA(nn.Module):
def __init__(self,in_channels):
super(Inception,self).__init__()
self.branch1x1=nn.Conv2d(in_channels,16,kernel_size=1)
self.branch5x5_1=nn.Conv2d(in_channels,16,kernel_size=1)
self.branch5x5_2=nn.Conv2d(16,24,kernel_size=5,padding=2)
self.branch3x3_1=nn.Conv2d(in_channels,16,kernel_size=1)
self.branch3x3_2=nn.Conv2d(16,24,kernel_size=3,padding_size=1)
self.branch3x3_3=nn.Conv2d(24,24,kernel_size=3,padding_size=1)
self.branch_pool=nn.Conv2d(in_channels,24,kernel_size=1)
def forward(self,x):
branch1x1=self.branch1x1(x)
branch5x5=self.branch5x5_1(x)
branch5x5=self.branch5x5_2(branch5x5)
branch3x3=self.branch3x3_1(x)
branch3x3=self.branch3x3_2(branch3x3)
branch3x3=self.branch3x3_3(branch3x3)
branch_pool=F.avg_pool2d(x,kernel_size=3,stride=1,padding=1)
branch_poll=self.branch_pool(branch_pool)
outputs=[branch1x1,branch5x5,branch3x3,branch_pool]
return torch.cat(outputs,dim=1)class Net(nn.Module):
def __init__(self):
super(Net,self).__init__()
#这里第一个参数是1意味着输入单通道
self.conv1=nn.Conv2d(1,10,kernel_size=5)
self.conv2=nn.Conv2d(88,20,kernel_size=5)
self.incep1=InceptionA(in_channels=10)
self.incep2=InceptionA(in_channels=20)
self.mp=nn.MaxPool2d(2)
self.fc=nn.Linear(1408,10)
def forward(self,x):
in_size=x.size(0)
x=F.relu(self.mp(self.conv1(x)))
x=self.incep1(x)
x=F.relu(self.mp(self.conv2(x)))
x=self.incep2(x)
x=x_view(in_size,-1)
#全连接
x=self.fc(x)
return x**We need to Go Deeper
Can we stack layers to go deeper?
**CIFAR-10
20层的卷积比50层的卷积性能却更好
**梯度消失 ** Deep Residual Learning: Residual net 手绘图源文件:Drawing 2026-05-01 10.52.17.excalidraw
**最终我们发现,即使很小我们的梯度也不为0而是1 最终无数个约为1的梯度相乘很好的解决了梯度消失的问题
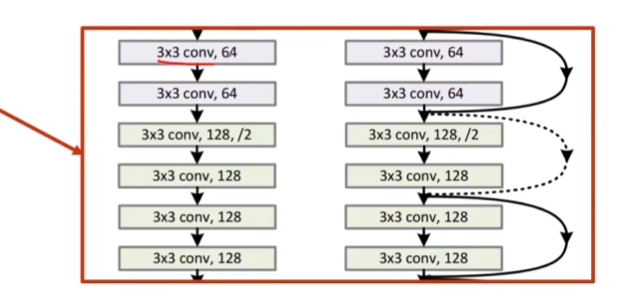
Residual NetWork:(残差结构快)
Plain Net VS Residual Net
Implementation Of Simple Residual Network
class ResidualBlock(nn.Module):
	def __init__(self,channels):
		super(ResidualBlock,self).__init__()
		self.channels=channels
		self.conv1=nn.Conv2d(channels,channels,kernel_size=3,padding=1)
		self.conv2=nn.Conv2d(channels,channels,kernel_size=3,padding=1)
	def forward(self,x):
		y=F.relu(self.conv1(x))
		y=self.conv2(y)
		#Residual Block
		return F.relu(x+y)
class Net(nn.Module):
def __init__(self):
super(Net,self).__init__()
self.conv1=nn.Conv2d(1,16,kernel_size=5)
self.conv2=nn.Conv2d(16,32,kernel_size=5)
self.mp=nn.MaxPool2d(2)
self.rblock1=ResidualBlock(16)
self.rblock2=ResidualBlock(32)
self.fc=nn.Linear(512,10)
def forward(self,x):
in_size=x.size(0)
x=self.mp(F.relu(self.conv1(x)))
x=self.rblock1(x)
x=self.mp(F.relu(self.conv2(x)))
x=self.rblock2(x)
x=x.view(in_size,-1)
x=self.fc(x)
return x增量式开发
Exercise:Reading Paper And Implementing
- **Identity Mappings in Deep Network
- **Densrly Connected Convolutional NetWorks