
BidirectionalEncoderRepresentations fromTransformers Bert是一个Encoder-Only的架构,采用了Transformer中的Encoder部分的架构
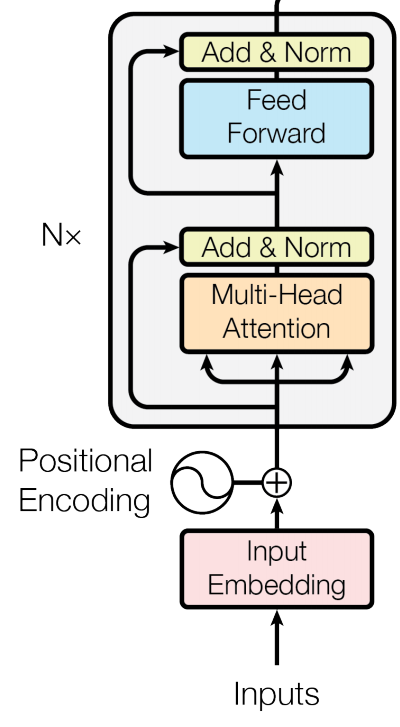
Bert将Encoder Module的层数用L表示,Token Embedding和隐藏层大小用H表示,自注意力用A表示。
Bert_base:(L=12,H=768,A=12)总参数量为110M,这个大小和GPT-1是同等参数Bert_Large:(L=24,H=1024,A=16)总参数量340M
Input and Output
解决:
- 序列级别的问题:
- 判断一句话positive or negetive
- 判断两句话的蕴藏关系
- Token级别的问题:为每个token输出它在上下文中的含义信息
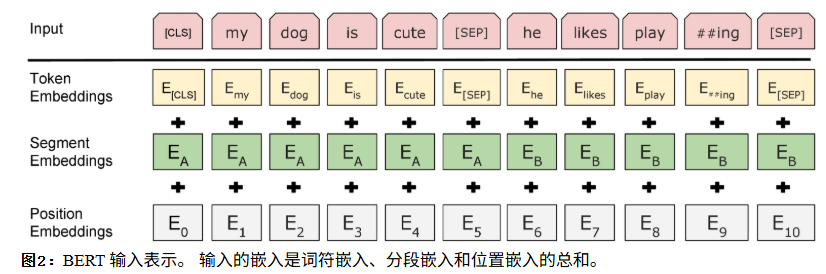
- [cls]token在输入前添加,将来在BERT Encoder Block最后一层第一个位置的输出vector
- [seq]token 序列的分隔符 对于 token 级别的任务,每个token位置最后一次encoder的输出的向量代表了这个token结合上下文后的表示信息,加一个分类头进行NER(name entity recognition) 分类,所有token共享1个分类头
NER(Named Entity Recognition,命名实体识别) 是自然语言处理(NLP)中的一项基础任务,目的是从文本中识别出具有特定意义的实体,并将其分类到预定义的类别中。
3个embedding:
- Token embedding,每个token的词用量,代表立刻每个token的原始含义,此时无上下文信息。vocab中每个token都有1个embedding,并且是可学习的参数
- Segment embedding,区分每个token属于哪个序列的enbedding,每个序列共享一个embedding,可学习参数
- Position embedding,给每个位置1个embedding,不同于transformer中的sin和cos,这里的position embedding也是可学习参数