
注意力机制
Q K V
Q(Query)、K(Key)、V(Value)
RNN中的QK
RNN中的注意力机制:Q就是当前Decoder时间步输入的隐状态,V和K一样,是Encoder每个时间步输出的隐状态。最终计算结果就是Q和K计算出注意力权值,经过softmax归一化后,按注意力机制对V进行加权求和,得到了注意力上下文向量了。 RNN中计算Q和K的值,是通过将Q和K向量进行拼接,然后经过1个神经网络,输出一个值。1个Q和一组K分别计算,得到1组logits,这一组logits再经过softmax,得到这一个Q和一组K的注意力权重
Transformer中的注意力机制
Transformer中,直接计算Q和K的点乘
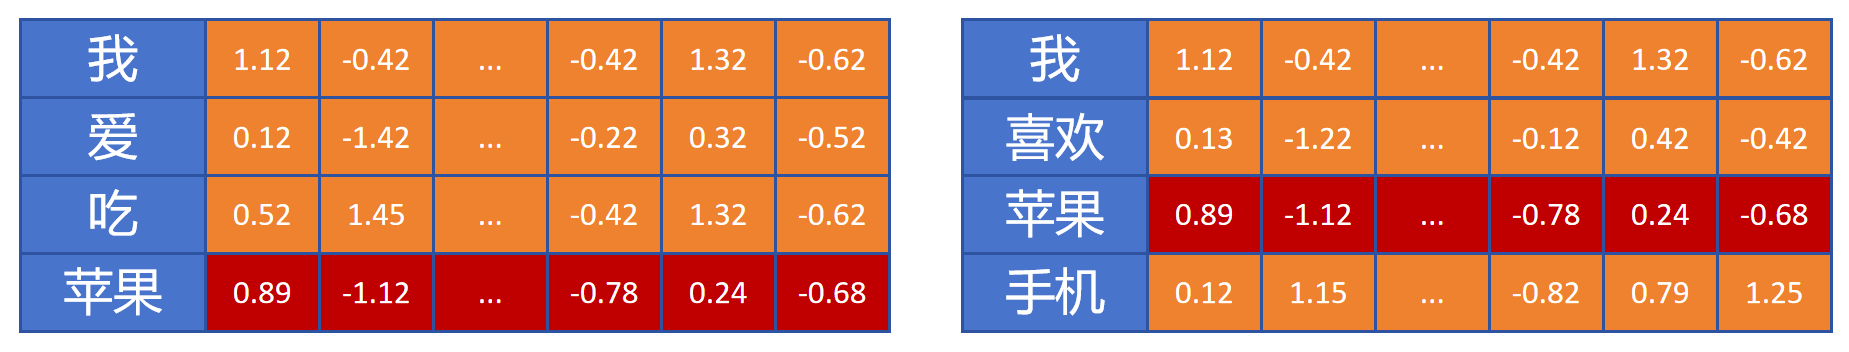
在不同的句子中 一个Token的Embedding是不同的
自注意力机制
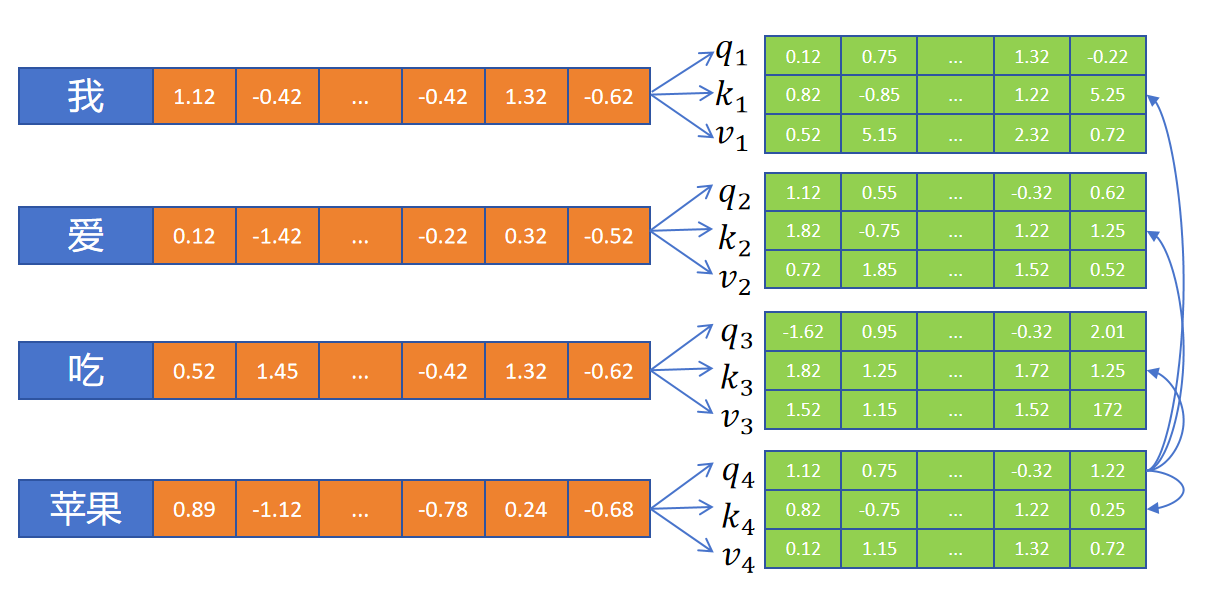
首先定义3个FNN,为每个token都生成各自的q、k、v向量。全连接层的输入都是当前的Embedding。有了当前的qkv向量就可以按章上面的方式进行注意力计算
苹果这个token,用自己的q向量和所有的token(包括自身)的k向量进行点积计算,得到1组A
softmax一下:
随后对所有的token的V向量进行加权求和,得到了苹果这个token根据上下文进行注意力更新后的新的Embedding表示:
多头注意力机制
在CNN中,每一层可以定义多个卷积核,每个卷积核发现不同的特征 注意力机制中的头也是如此的作用,一个头用于发现这个token的某种特性 这个头中的q\k\v分别用于查询应答和提供这个特性的表示值 每个头计算自己的注意力权重,并对这个头内部的v加权求和,得到这个头的输出,然后每个头的输出拼接,就构成了一个token经过了多头自注意力更新后的embedding向量了 为了保证更新前后每个token的Embedding维度不变,假如注意力有N个头,那么每个头的qkv的维度就为原始token Embedding的1/N,最后N个头进行注意力计算后的输出拼接,Embedding的维度就保持不变了
矩阵运算加速
Transformer一个重大优势是:可以同时更新所有的token的embedding,不用像RNN计算每个token的隐状态需要等待前面token依次计算出各自的隐状态
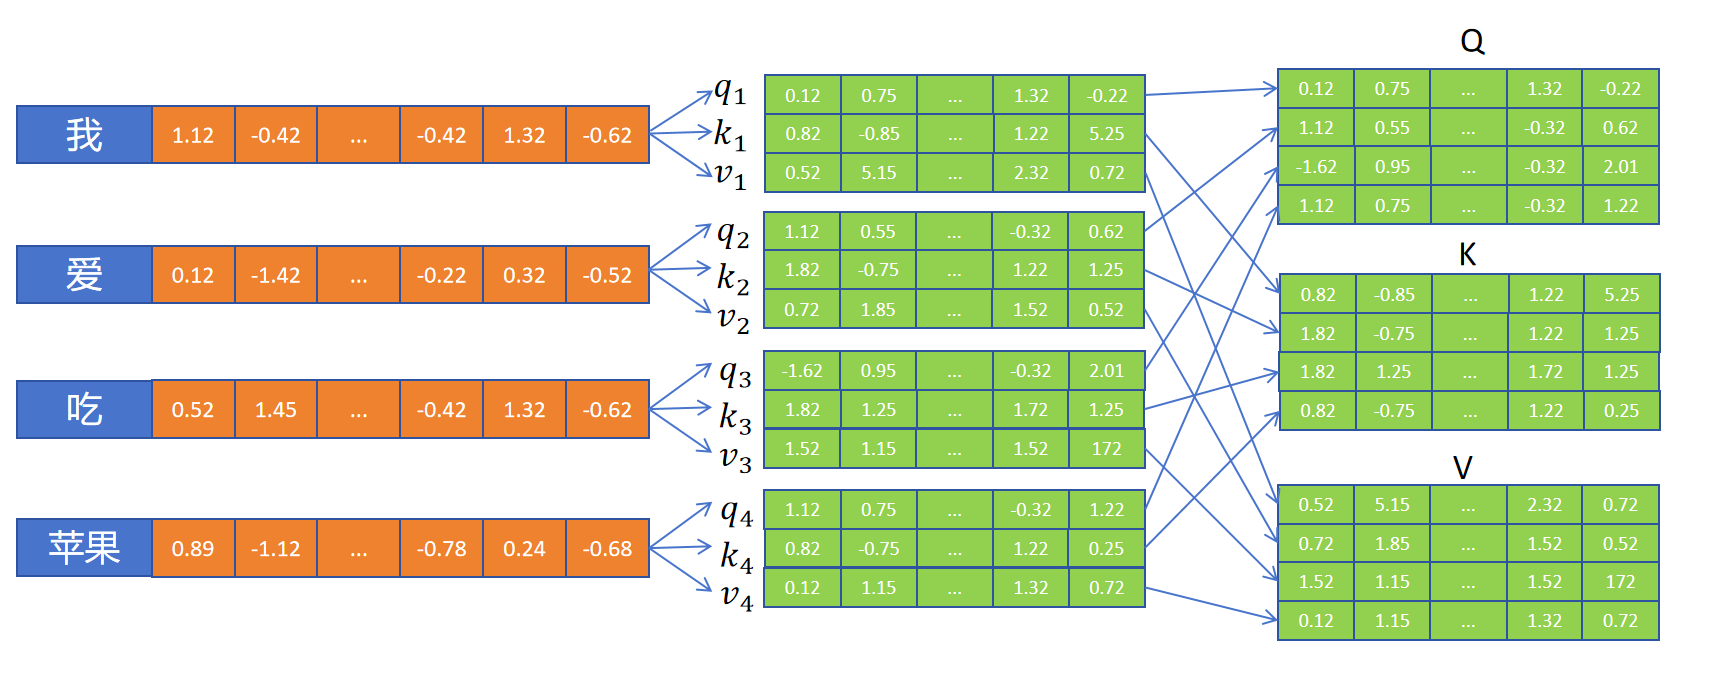
又有GPU极其擅长矩阵运算: qkv的向量维度和embedding向量的维度都一样,为hidden_size,所以将序列内所有token产生的q向量合并在一起,形成一个Q矩阵[seq_len,hidden_size],K矩阵形状为[seq_len,hidden_size]又V矩阵[seq_len,hidden_size],Q乘以K的转置得到的结果的形状为:[seq_len,seq_len],然后softmax之后就得到了注意力权重矩阵
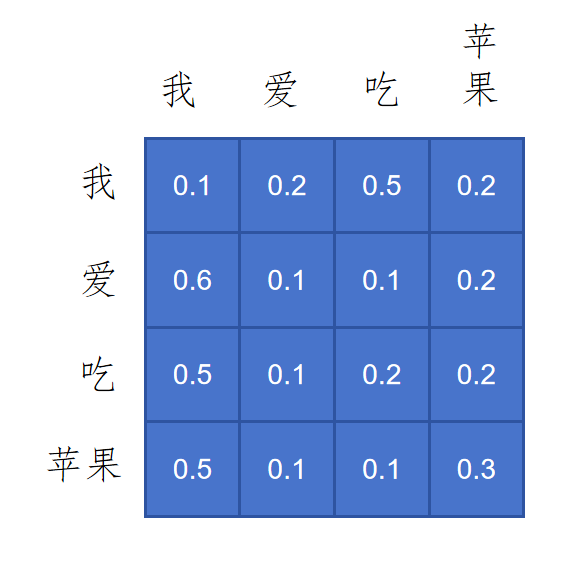
其中结果的第一行表示第一个token和序列里每个token注意力权重的值。第n行的每个值表示序列里第n个token和序列所有token计算的注意力权重值。 然后这个注意力权重矩阵再与V相乘得到这个注意力层的输出,也就是对序列所有token根据上下文,应用注意力机制更新后的embedding:
改进一点使之更稳定
就是特征维度hidden_size
YesButWhy? 特征维度是一个超参数,可以调节,如果特征值分布一致,特征维度越大,那么2个特征向量点乘后的softmax分布十分尖锐,注意力集中再几个token上,其他token的信息就利用不上
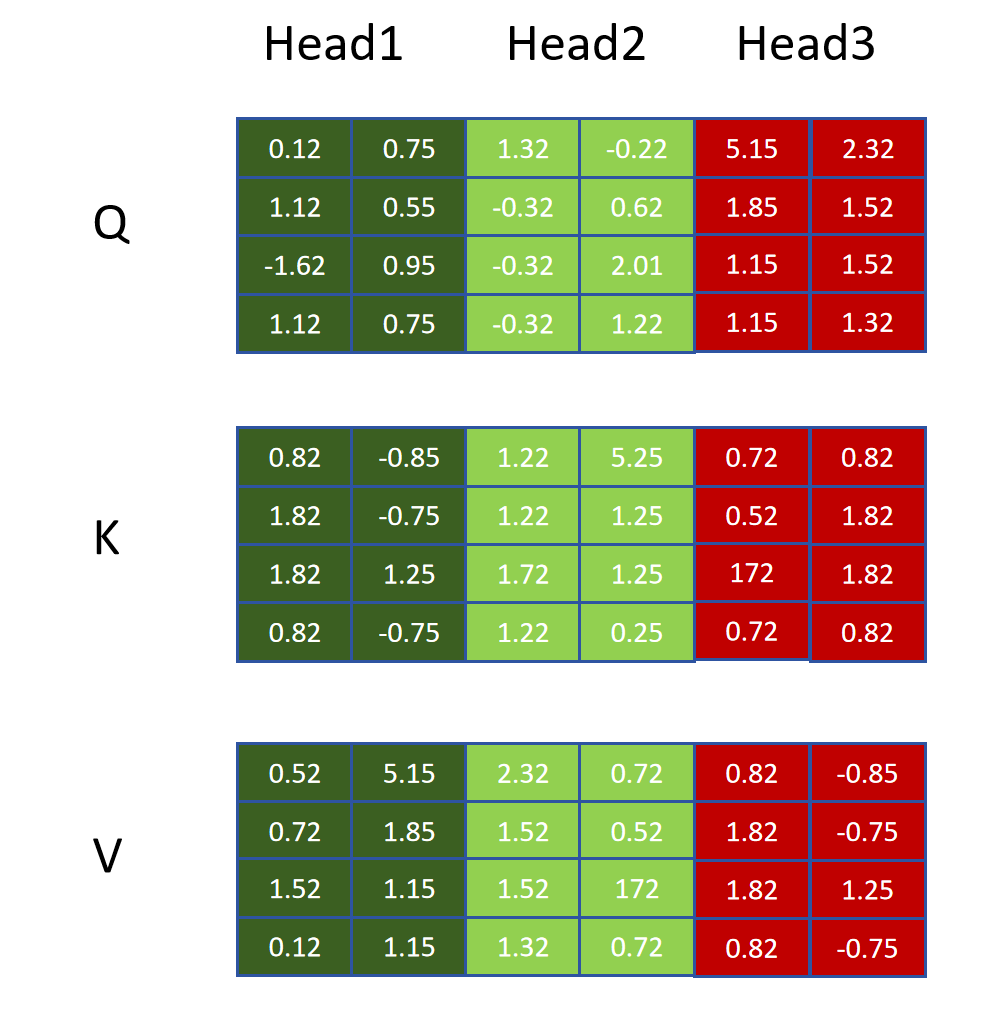
Transformer在为每个token生成q,k,v向量时,生成的维度和embedding的维度是一致的,然后再按头的个数划分为多个q,k,v,代表每个头的q,k,v。 整个序列的4个token进行多注意力计算时就是Head1Head2Head3的QKV矩阵进行计算,分别得到结果矩阵,再将矩阵进行拼接,得到了4个token的Embedding
一个完整的注意力机制还会通过1个全连接层整理token的embedding
Pytorch实现
class MultiHeadAttentionBlock(nn.Module):
	def __init__(self,d_model:int,h:int,dropout:float)->None:
		super().__init__()
		self.d_model=d_model#embeding特征
		self.h=h#头的数量

		assert d_model%h==0,"D_model Out"

		self.d_k=d_model//h
		self.w_q = nn.Linear(d_model,d_model,bias=False)
		self.w_k = nn.Linear(d_model,d_model,bias=False)
		self.w_v = nn.Linear(d_model,d_model,bias=False)
		self.w_o = nn.Linear(d_model,d_model,bias=False)
		self.dropout = nn.Dropout(dropout)

	def attention(query,key,value,mask,dropout:nn.Dropout):
		d_k = query.shape[-1]
		attention_scores = (query@key.transpose(-2,-1)/math.sqrt(d_k))
		if mask is not None:
			#对零值加一个极大的负数,使之softmax输出近乎为0
			attention_scores.masked_fill_(mask==0,-1e9)
		attention_scores=attention_scores.softmax(dim=-1)
		if dropout is not None:
			attention_scores=dropout(attention_scores)
		return (attention_acores@value),attention_scores

	def forward(self,q,k,v,mask):
		query = self.w_q(q)
		key = self.w_k(k)
		value = self.w_v(v)

		# 多头进行拆分 (batch,seq_len,d_model)->(batch,seq_len,h,d_k)
		query = query.view(query.shape[0],query.shape[1],self.h,self.d_k)
		key = key.view(key.shape[0],key.shape[1],self.h,self.d_k)
		value = value.view(value.shape[0],value.shape[1],self.h,self.d_k)

		x,self_attention = MultiHeadAttentionBlock.attention(query,key,value,mask,self.dropout)

		#合并多个头
		x = x.transpose(1,2).contiguous().view(x.shape[0],-1,self.h*self.d_k)
		return self.w_o(x)
层归一化
序列问题的一大特点时序列长度是可变的,为了让这些可变长度的序列放入维度固定的tensor,会在1个batch里短的序列后面填充<pad>token,如果用BatchNorm: 序列很长,batchsize很小,不同baatch之间均值方差差距很大 大量的<pad>会影响正常token的均值和方差计算
Layer Norm
按照每个token来统计每个token所有特征的均值方差,然后在token特征的每个维度都定义2个可学习参数和来进行线性变化
如果是1个512d的数据,则对512个维度分别求均值和方差,并且所有token共享和参数
class LayerNormaliztion(nn.Module):

	def __init__(self,features:int,eps:float = 10**-6)->None:
		super().__init__()
		self.eps=eps
		self.aplha = nn.Parameter(torch.ones(features))
		self.bias = nn.Parameter(torch.ones(features))

	def forward(self,x):
		mean = x.mean(dim=-1,keepdim=True)
		std = x.std(dim=-1,keepdim=True)
		return self.alpha*(x-mean)/(std+self.std)+self.bias
位置编码
序列问题最主要的特征就是数据的顺序是很重要的
绝对位置比那吗
绝对位置编码的问题就是训练时的数据长度是固定的,位置编码每个维度的数值只能是0或者1,若是预测时序列长度大于训练的长度,模型就无效了
好的位置编码
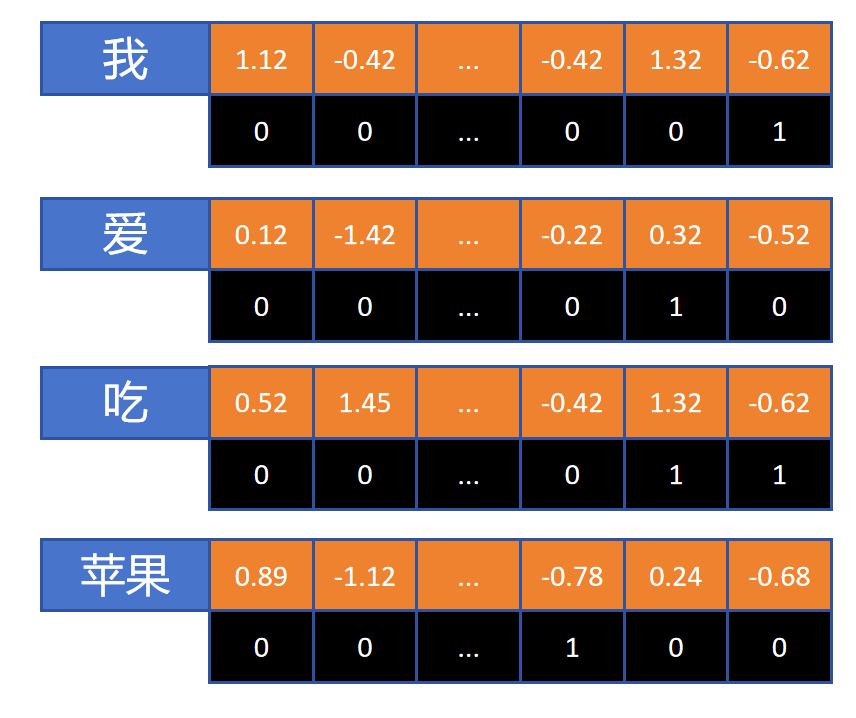
每个维度都是连续值,这样即使出现更长的序列,只需要一个更大的数字表示;且位置编码的低维度变化快,高维数字变化慢,每个维度都是周期性变化
Sin函数位置编码
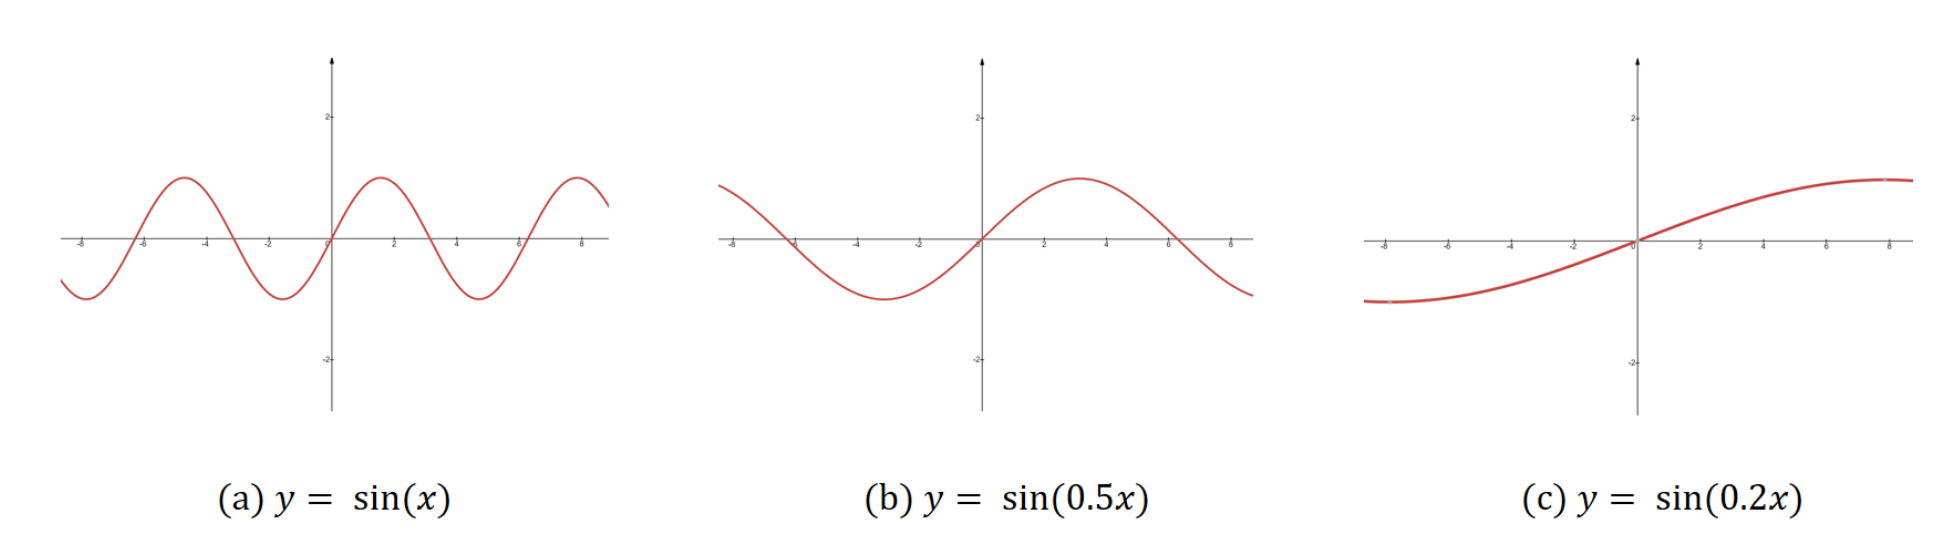
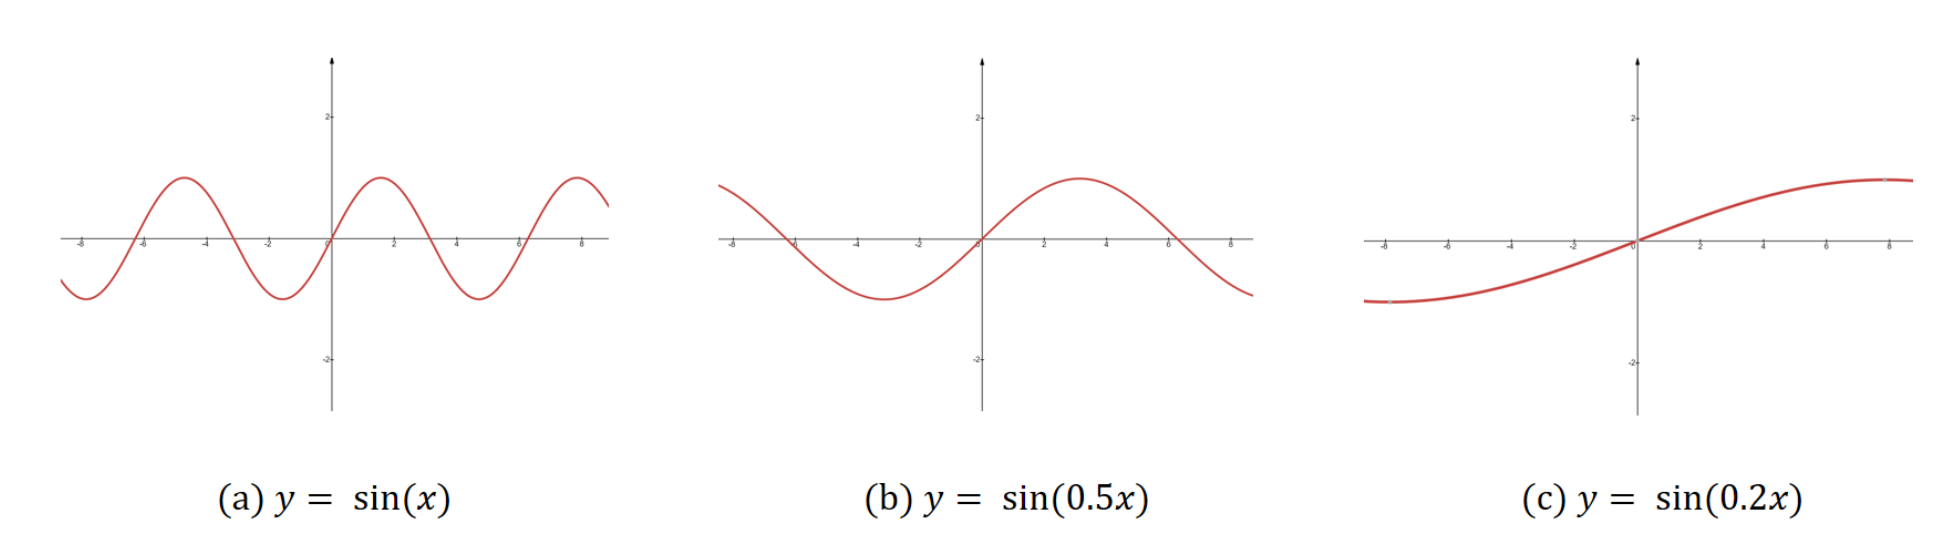
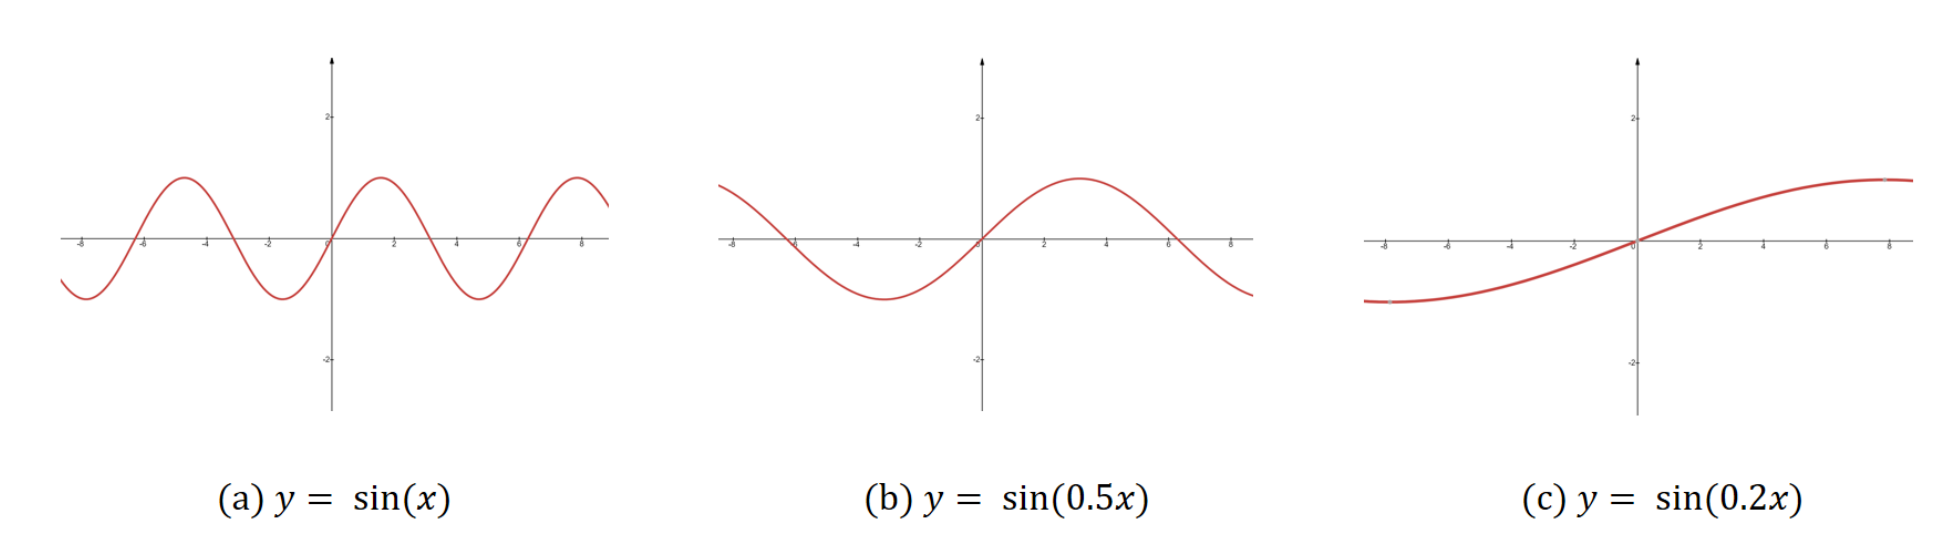
可以通过调整波长,来决定函数随时变的快慢。因此可以用sin函数来做位置编码;低维度用波长短的sin函数这样值变化快;高维度用波长长的sin函数,这样值变化慢 对于一个512维的位置编码,我们可以如下定义:
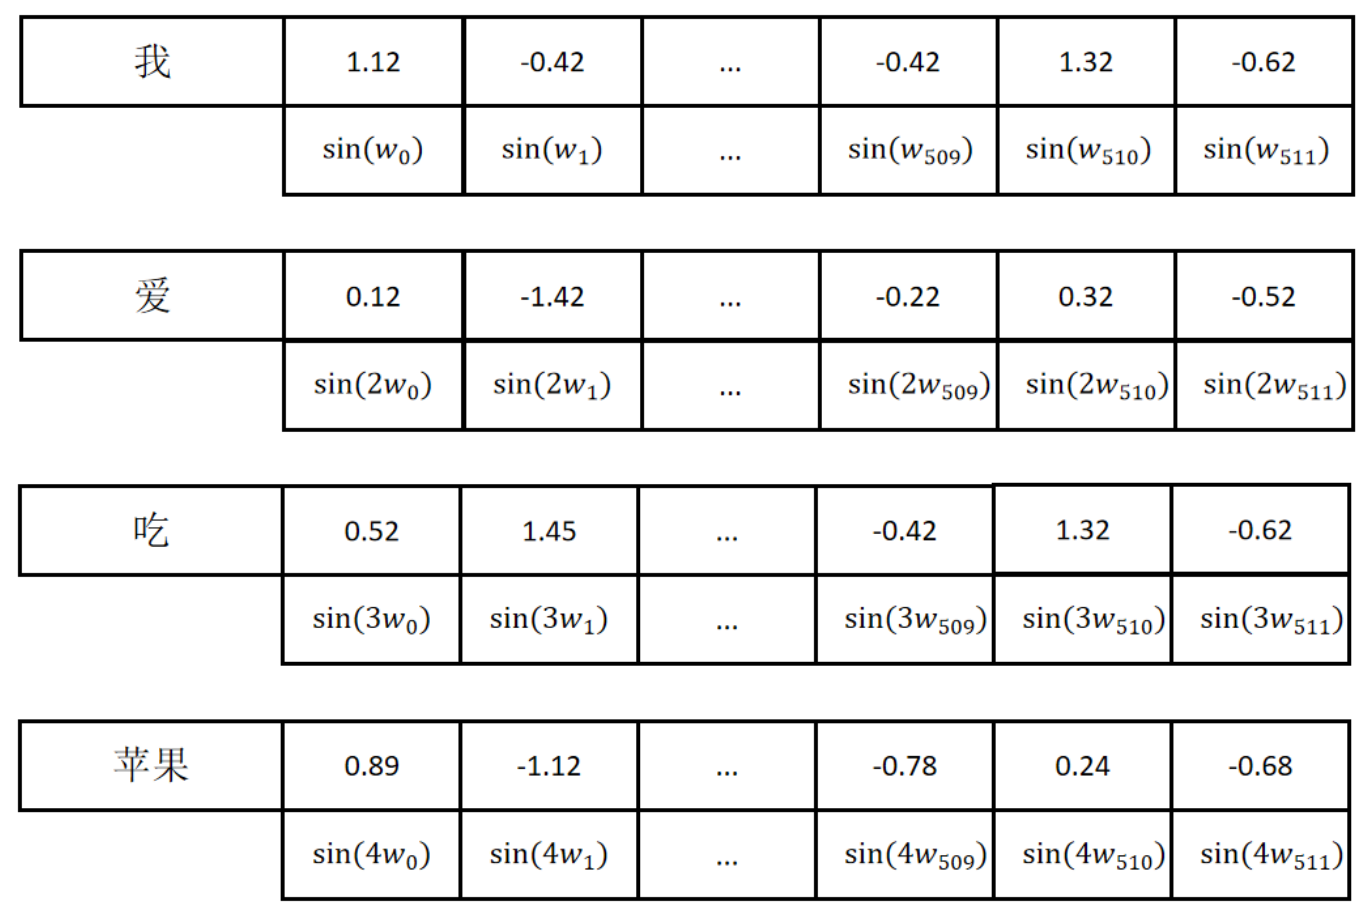
上图中偶数位置用sin函数系数表示,奇数位置用表示
而注意力机制是通过q和k向量的点积来计算的,对于用sin和cos交替进行编码的2个位置向量,一个位置是t一个位置是t+ 对这2个位置编码进行点积运算如下:
易得: 最后注意力计算结果*只与两个位置之间的相对位置有关,而与绝对位置无关**
class PositionalEncoding(nn.Module):
	def __init__(self,d_model:int,seq_len:int,dropout:float)->None:
		super().__init__()
		self.d_model=d_model
		self.seq_len=seq_len
		self.dropout = nn.Dropout(dropout)
		# 创建一个空的tensor
		pe = torch.zeros(seq_len,d_model)
		position = torch.arange(0,seq_len,dtype=torch.float).unsqueeze(1)
		div_term = torch.pow(10000.0,-torch.arange(0,d_model,2,dtype=torch.float)/d_model)

		#偶数位用sin
		pe[:,0::2]=torch.sin(position*div_term)
		pe[:,1::2]=torch.cos(position*div_term)

		pe=pe.unsqueeze(0)
		self.register_buffer('pe',pe)

	def forward(self,x):
		x = x+(self.pe[:, :x.shape[1],:]).requires_grad_(False)
		return self.dropout(x)
Transformer
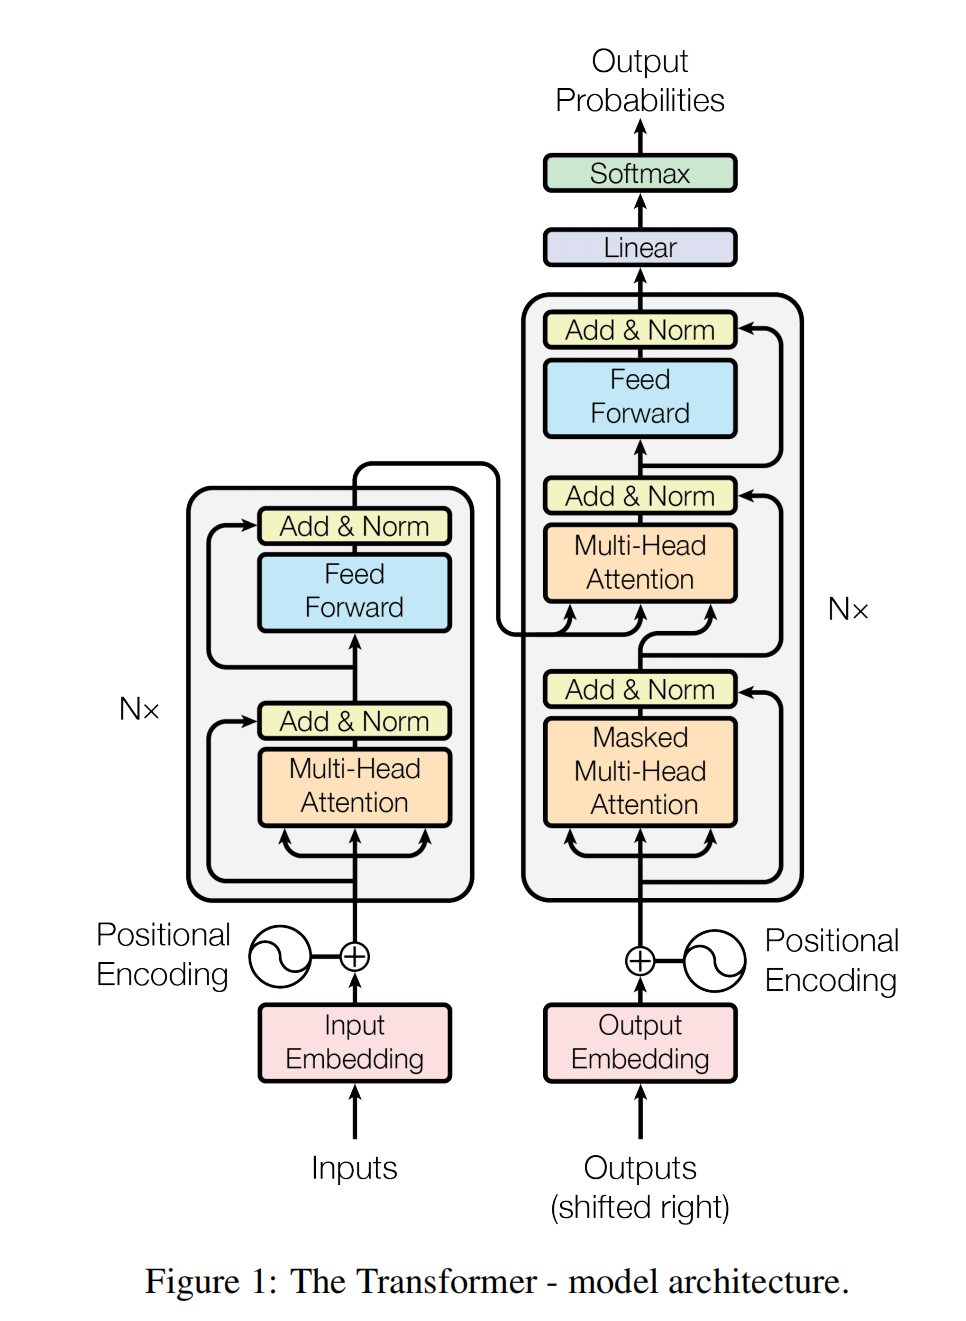
Encoder
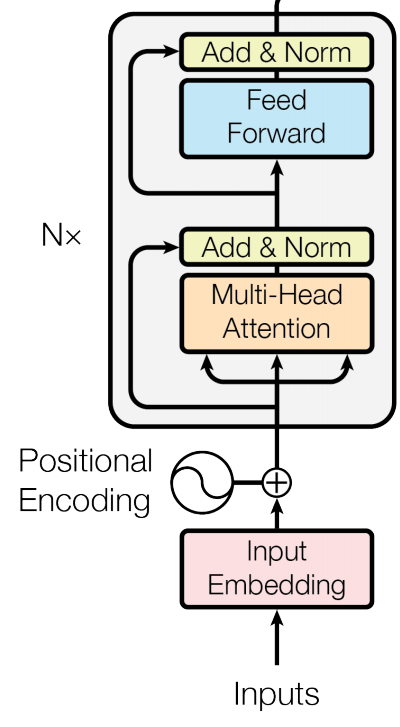
Inputs->Embedding->N个Encoder Block EncoderBlock: 多头注意力->残差链接->Layer Norm->FNN->残差连接->Layer Norm 全连接模块实现:
class FeedForwardBlock(nn.Module):
	def __init__(self,d_model:int,d_ff:int,dropout:float)->None:
		super().__init__()
		self.linear_1=nn.Linear(d_model,d_ff)
		self.dropout=nn.Dropout(dropout)
		self.linear_2=nn.Linear(d_ff,d_model)

	def forward(self,x):
		return self.linear_2(self.dropout(torch.relu(linear_1(x))))
全连接定义了2层,先将每个token embedding的维度拓展,然后应用了ReLU激活,接着进行dropout;第二层将拓展的维度又将为d_model
Add&Norm实现:
class ResidualConnection(nn.Module):
	def __init__(self,features:int,dropout:float)->None:
		super().__init__()
		self.dropout = nn.Dropout(dropout)
		self.norm = LayerNormalization(features)
	def forward(self,x,sublayer):
		return x+self.dropout(sublayer(self.norm(x)))
Encoder完整:
class EncoderBlock(nn.Module):
	def __init__(self,features:int,self_attention_block:MultiHeadAttentionBloack,feed_forward_block:FeedForwardBlock,dropout:float)->None:
		super().__init__()
		self.self_attention_block = self_attention_block;
		self.feed_forward_block = feed_forward_block;
		self.residual_connections = nn.ModuleList(x,self.feed_forward_block)

	def forward(self,x,src_mask):
		# 第一个残差连接,跳过多头注意力模块
		x = self.residual_connections[0](x,lamba x:self.self_attention_block(x,x,x,src_mask))
		x = self.residual_connections[1](x,self.feed_forward_block)

class Encoder(nn.Module):
	def __init__(self,features:int,layers:nn.ModuleList)->None:
		super().__init__()
		#传入的6个EncoderBlock
		self.layer = layers
		self.norm = LayerNormlization(features)

	def forward(self,x,mask):
		for layer in self.layers:
			x = layer(x,mask)
		return self.norm(x)
Decoder
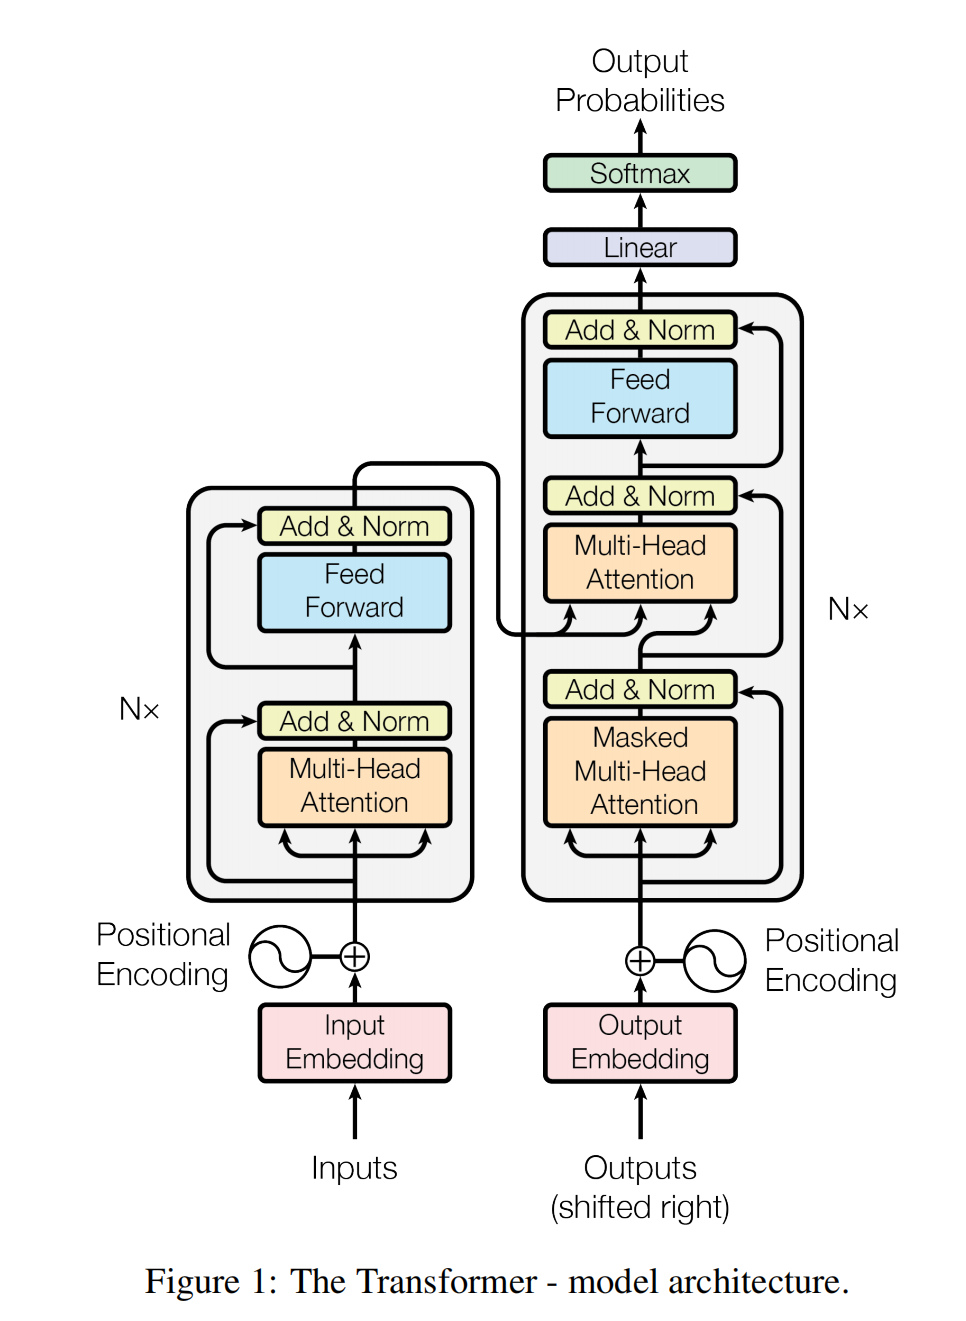
Decoder的输入:
- 含有上下文信息的编码器的输出的token Embedding
- 已经翻译好的token序列 在训练时,由于我们已经知道英文对应的中文token序列,所以可以通过一种叫做带掩码的多头注意力机制来实现并行化训练
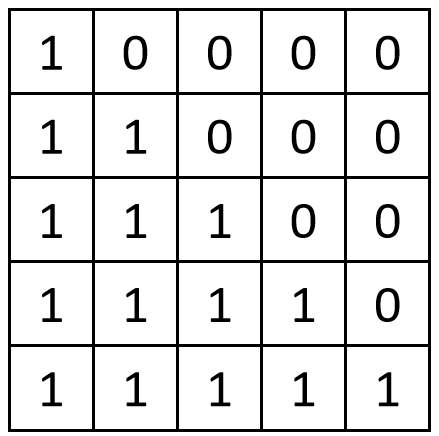
对于”我爱吃苹果”这个序列,可以构造1个下三角矩阵: Transformer中只有注意力计算是跨token,根据上下文更新自身embedding的;进行注意力计算时,除传入qkv之外,还需要传入这个Mask MaTrix 实际代码实现时,先利用QK矩阵进行注意力计算,softmax()之前,吧Mask矩阵为0的注意力结果填充为1个很大的负值,softmax之后就是0
def attention(query,key,value,mask,dropout:nn.Dropout):
	d_k = query.shape[-1]
	#(batch,h,seq_len,d_k)->(batch,h,seq_len,seq_len)
	if mask is not None:
		# 给mask为0的位置填入了极大的负值
		attention_scores.masked_fill_(mask==0,-1e9)
	attention_scores = attention_scores.softmax(dim=1)
	if dropout is not None:
		attention_scores = dropout(attention_scores)
	return (attention_acores@values),attention_score
Mask机制只能在训练时一次性对解码器所在位置的token进行训练;但是在训练完进行生成时,实现不知道答案,只能一步一步生成一个新的token,然后拼接到解码器的输入
CrossAttention
Transformer有6个DecoderBlock每个DecoderBlock有2的注意力模块,一个全连接模块 交叉注意力模块的K和V来自编码器的输出: Q来自解码器部分; 所以Decoder需要根据当前需要提出查询向量q,和所有Encoder输出的k进行匹配,计算注意力,最终得到编码器输出的v的注意力加权值
def forward(self,x,encoder_output,src_mask,tgt_mask):
	#第一个自注意力模块:qkv均来自本身
	x = self.residual_connections[0](x,lambda x:self.self_attention_block(x,x,x,mask))
	#第2个交叉注意力模块:q来自本身;kv来自encoder的输出
	x = self.residual_connections[1](x,lambda x:self.cross_attention_block(x,encoder_output,encoder_output,src_mask))
	# FNN
	x = self.residual_connections[2](x,self.feed_forward_block)
	return x
Decoder 实现
class DecoderBlock(nn.Module):
	def __init__(self,features:int,self_attention_block:MultiHeadAttentionBlock,cross_attention_block:MultiHeadAttentionBlock,feed_forward_block:FeedForwardBlock,dropout:float)->None:
		super().__init__()
		self.self_attention_block=self_attention_block
		self.cross_attention_block = cross_attention_block
		self.feed_forward_block = feed_forward_block
		self.residual_connections = nn.ModelList([ResidualConnections(features,dropout) for _ in range(3)])

	def forward(self,x,encoder_output,src_mask,tgt_mask):
		x = self.residual_connections[0](x,lambda x:self.self_attention_block(x,x,x,tgt_mask))
		x = self.residual_connections[1](x,lambda x:self.cross_attention_block(x,encoder_output,encoder_output,src_mask))
		x = self.residual_connections[2](x,self.feed_forward_block)

class Decoder(nn.Module):
	def __init__(self,features:int,layers:nn.ModuleList)->None:
		super().__init__()
		self.layer=layers
		self.norm=LayerNormalization(features)
	def forward(self,x,encoder_output,src_mask,tgt_mask):
		for layer in self.layers:
			x = layer(x,encoder_output,src_mask,tgt_mask)
		return self.norm(x)