
AlexNet
2012年,AlexNet横空出世
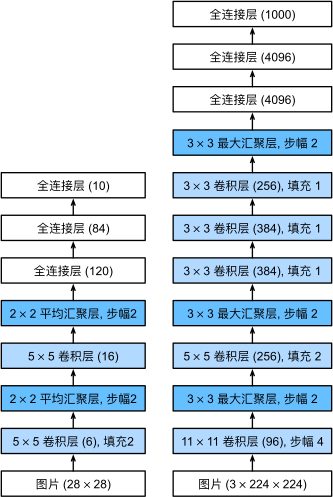
AlexNet通过暂退法控制全连接层的模型复杂度,LeNet只用了权重衰减,且AlexNet在训练时加入了大量的图像增强数据,使得模型更为健壮
import torch
from torch import nn
from d2l import torch as d2l

net = nn.Sequential(
	# 11*11的卷积窗口
	# stride=4
	# 输出通道大幅增加
	nn.Conv2d(1,96,kernel_size=11,stride=4,padding=1),nn.ReLU(),
nn.MaxPool2d(kernel_size=3,stride=2)
nn.Conv2d(95,256,kernel_size=5,padding=2),nn.ReLU(),
nn.MaxPool2d(kernel_size=3,stride=2),
	# 使用3个连续的卷积层和较小的卷积窗口
nn.Conv2d(256,384,kernel_size=3,padding=1),nn.ReLU()
nn.Conv2d(384,364,kernel_size=3,padding=1),nn.ReLU()
nn.Conv2d(384,256,kernel_size=3,padding=1),nn.ReLU()
nn.MaxPool2d(kernel_size=3,stride=2)
nn.Flatten(),

nn.Linear(6400,4096),nn.ReLU(),
nn.Dropout(p=0.5)
nn.Linear(4096,4096),nn.ReLU(),
nn.Dropout(p=0.5)

nn.Linear(4096,10)
)
X = torch.randn(1,1,224,224)
for layer in net:
X=layer(X)
print(layer.__class__.__name__,'output shape:\t',X.shape)读取数据集
batch_size = 128
train_iter,test_iter = d2l.load_data_fashion_mnist(batch_size,resize=224)
训练AlexNet
lr,num_epoches = 0.01,10
d2l.train_ch6(net,train_iter,test_iter,num_epoches,lr,d2l.try_gpu())
Practice
-
试着增加迭代轮数。对比LeNet的结果有什么不同?为什么?
-
AlexNet对Fashion-MNIST数据集来说可能太复杂了。
-
尝试简化模型以加快训练速度,同时确保准确性不会显著下降。
-
设计一个更好的模型,可以直接在图像上工作。
-
-
修改批量大小,并观察模型精度和GPU显存变化。
-
分析了AlexNet的计算性能。
-
在AlexNet中主要是哪部分占用显存?
-
在AlexNet中主要是哪部分需要更多的计算?
-
计算结果时显存带宽如何?
-
-
将dropout和ReLU应用于LeNet-5,效果有提升吗?再试试预处理会怎么样?