
GoogLeNet
Inception块
GoogLeNet中,基本的卷积块被称之Inception Block
We Need To Go Deeper
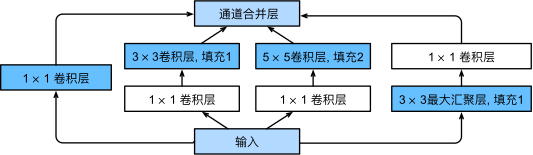
神之配比:
import torch
from torch import nn
from torch.nn import functioanl as F
from d2l import torch as d2l

class Inception(nn.Module):
	def __init__(self,in_channels,c1,c2,c3,c4,**kwargs):
		super(Inception,self).__init__(**kwargs)
		self.p1_1=nn.Conv2d(in_channels,c1,c2,c3,c4,**kwargs)
		self.p2_1=nn.Conv2d(in_channels,c2[0],kernel_size)
		self.p2_2=nn.Conv2d(c2[0],c2[1],kernel_size)
		self.p3_1=nn.Conv2d(in_channels,c2[0],kernel_size=1)
		self.p3_2=nn.Conv2d(c3[0],c3[1],kernel_size=5,padding=2)
		self.p4_1=nn.MaxPool2d(kernel_size=3,stride=1,padding=1)
		self.p4_2=nn.Conv2d(in_channels,c4,kernel_size=1)
	def forward(self,x):
		p1=F.relu(self.p1_1(x))
		p2=F.relu(self.p2_2(F.relu(self.p2_1(x))))
		p3=F.relu(self.p3_2(F.relu(self.p3_1(x))))
		p4=F.relu(self.p4_2(self.p4_1(x)))
	return torch.cat((p1,p2,p3,p4),dim=1)
GoogLeNet模型
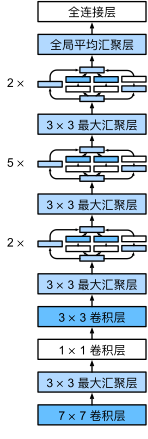
穷人靠变异,富人靠科技
b1 = nn.Sequential(nn.Conv2d(1,64,kernel_size=7,stride=2,padding=3),nn.ReLU(),nn.MaxPool2d(kernel_size=3,stride=2,padding=1))b2 = nn.Sequential(nn.Conv2d(64,64,kernel_size=1),nn.ReLU(),nn.Conv2d(64,192,kernel_size=3,padding=1),nn.ReLU(),nn.MaxPool2d(kernel_size=3,stride=3,padding=1))
b3 = nn.Sequential(Inception(192,64,(96,128),(16,32),32),Inception(256,128,(128,192),(32,96),64),nn.MaxPool2d(kernel_size=2,stride=2,padding=1)b4 = nn.Sequential(Inception(480,192,(96,208),(16,48),64),
Incepyion(512,160,(112,224),(24,64),64),
Inception(512,128,(128,256),(24,64),64),
Inception(512,112,(144,288),(32,64),64),
Inception(528,256,(160,320),(32,128),128),
nn.MaxPool2d(kernel_size=3,stride=2,padding=1))b5 = nn.Sequential(Inception(832,256,(160,320),(32,128),128),
Inception(832,384,(192,384),(48,128),128),
nn.AdaptiveAvgPool2d((1,1)),
nn.Flatten())
net = nn.Sequential(b1,b2,b3,b4,b5,nn.Linear(1024,10))X = torch.rand(size=(1,1,96,96))
for layer in net:
X=layer()
print(layer.__class__.__name__,'output shape:\t',X.shape)训练模型
lr,num_epoches,batch_size=0.1,10,128
train_iter,test_iter=d2l.load_data_fashion_mnist(batch_size,resize=96)
d2l.train_ch6(net,train_iter,test_iter,num_epoches,lr,d2l.try_gpu())
Peactice
-
GoogLeNet有一些后续版本。尝试实现并运行它们,然后观察实验结果。这些后续版本包括:
-
添加批量规范化层 (Ioffe and Szegedy, 2015)(batch normalization),在 7.5节中将介绍;
-
对Inception模块进行调整 (Szegedy et al., 2016);
-
使用标签平滑(label smoothing)进行模型正则化 (Szegedy et al., 2016);
-
加入残差连接 (Szegedy et al., 2017)。( 7.6节将介绍)。
-
-
使用GoogLeNet的最小图像大小是多少?
-
将AlexNet、VGG和NiN的模型参数大小与GoogLeNet进行比较。后两个网络架构是如何显著减少模型参数大小的?