
LeNet
- 卷积
- 全连接层密集块
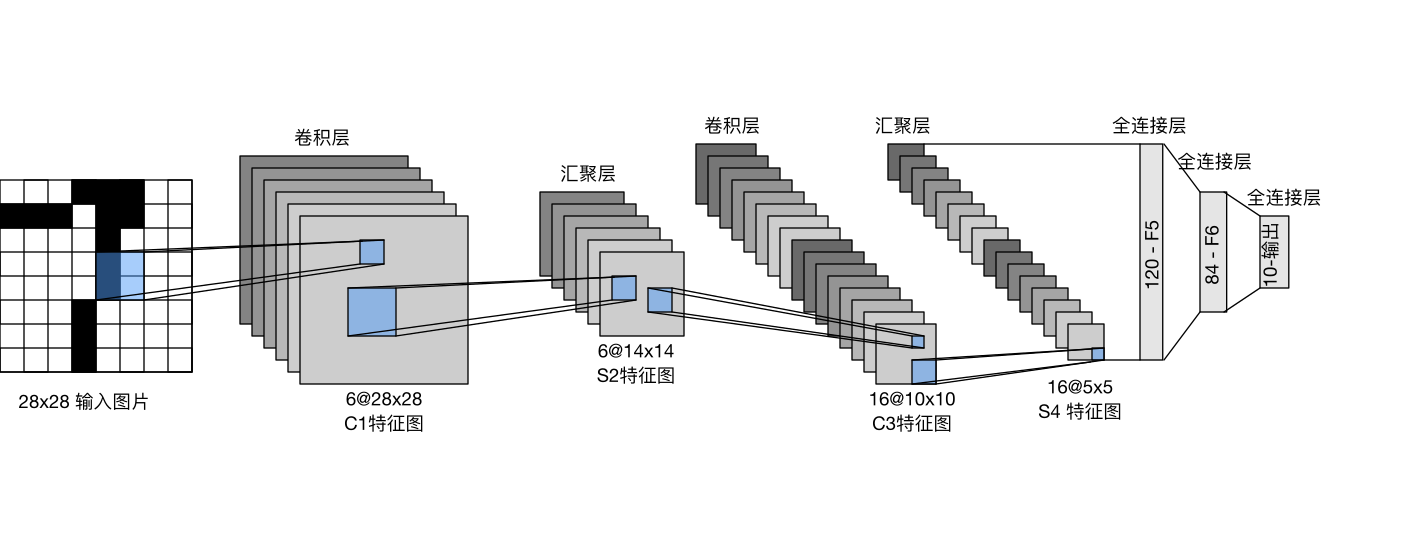
每个卷积块中的基本单元是一个卷积层一个sigmoid函数和平均池化层。每个卷积层用5*5卷积核和一个sigmoid激活函数。这些层将输入映射到多个二位特征输出,通常同时增加通道数 为了将卷积块的输出传递给稠密块,必须在小批量展平每个样本 flat->4维->2维: 第1个维度索引小批量中的样本; 第2个维度给出每个样本的平面向量表示
import torch
from torch import nn
from d2l import torch as d2l

net = nn.Sequential(
	nn.Conv2d(1,6,kernel_size=5,padding=2),nn.Sigmoid(),
	nn.AvgPool2d(kernel_size=2,stride=2)
	nn.Conv2d(6,16,kernel_size=5),nn.Sigmoid(),
	nn.AvgPool2d(kernel_size=2,stride=2),
	nn.Flatten(),
	nn.Linear(16*5*5,120),nn.Sigmoid(),
	nn.Linear(120,84),nn.Sigmoid(),
	nn.Linear(84,10)
)将1个大小为28*28的单通道(黑白图像)通过LeNet.
X = torch.rand(size=(1,1,28,28),dtype=torch.float32)
for layer in net:
	X = layer(X)
	print(layer.__class__.__name__,'output shape: \t',X.shape)
模型训练
batch_size = 256
train_iter,test_iter = d2l.load_data_fashion_mnist(batch_size=batch_size)
def evaluate_accuracy_gpu(net,data_iter,device=None):
if isinstance(net,nn.Module):
net.eval()
if not device:
device = next(iter(net.parameters())).device
metric = d2l.Accumulator(2)
with torch.no_grad():
for X,y in data_iter:
if isinstance(X,list):
X = [x.to(device for x in X)]
else:
X = X.to(device)
y = y.to(device)
metric.add(d2l.accuracy(net(X),y),y.numel())
return metric[0]/metric[1]def train_ch6(net,train_iter,test_iter,num_epoches,lr,device):
def init_weights(m):
if type(m) == nn.Linear or type(m) == nn.Conv2d:
nn.init.xaiver_uniform_(m,weight)
net.apply(init_weight)
print('training on',device)
net.to(device)
optimizer = torch.optim.SGD(net.parameters(),lr=lr)
loss = nn.CrossEntropyLoss()
animator = d2l.Animator(xlabel='epoch',xlim=[1,num_epoches],legend=['train loss','train_acc','test acc'])
timer,num_batches = d2l.Timer(),len(train_iter)
for epoch in range(num_epoches):
metric = d2l.Accumulator(3)
net.train()
for i,(X,y) in enumerate(train_iter):
timer.start()
optimizer.zero_frad()
X,y=X.to(device),y.to(device)
y_hat=net(X)
l=loss(y_hat,y)
l.backward()
optimizer.step()
with torch.no_grad():
metric.add(l*X.shape[0],d2l.accuracy(y_hat,y),X.shape[0])
timer.stop()
train_l = metric[0]/metric[2]
train_acc = metric[1]/metric[2]
if(i=1)%(num_batches//5)==0 or i==num_batches-1:
animator.add(epoch+1,(None,None,test_iter))
test_acc = evaluate_accuracy_gpu(net,test_iter)
animator.add(epoch+1,(None,None,test_iter))
print(f'loss{train_l:.3f},train_acc{train_acc:.3f},'f'test.acc{test_acc:.3f}')
print(f'{metric[2]*num_epoches/timer.sum():.1f} examples/sec 'f'on{str(device)}')Practice:
-
将平均汇聚层替换为最大汇聚层,会发生什么?
-
尝试构建一个基于LeNet的更复杂的网络,以提高其准确性。
-
调整卷积窗口大小。
-
调整输出通道的数量。
-
调整激活函数(如ReLU)。
-
调整卷积层的数量。
-
调整全连接层的数量。
-
调整学习率和其他训练细节(例如,初始化和轮数)。
-
-
在MNIST数据集上尝试以上改进的网络。
-
显示不同输入(例如毛衣和外套)时,LeNet第一层和第二层的激活值。