
NIN
NIN块
tersor:[batches,channels,height,width] NiN的想法是再每个像素位置应用1个全连接层,若是将权重连接到每个空间位置,可以视之为1*1卷积层,或者作为在每个像素位置上独立作用的全连接层
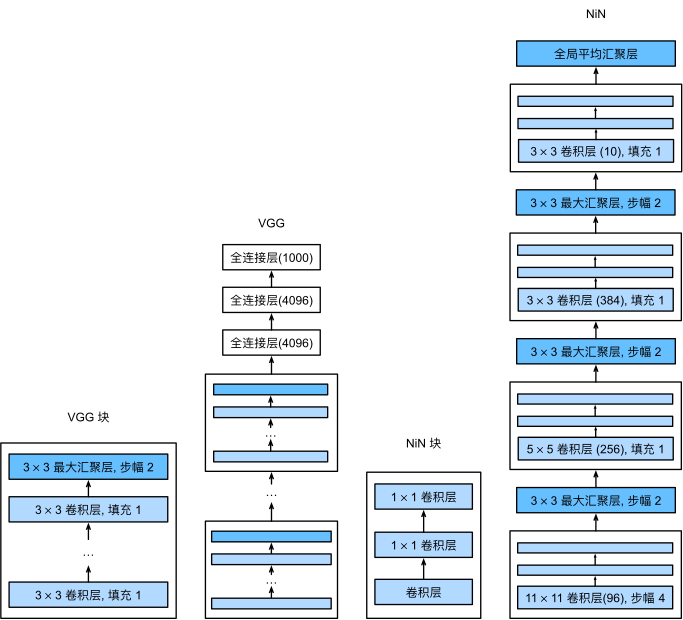
以一个卷积层开始,后面两个1x1卷积层->充当含ReLU激活函数的之像素全连接层
import torch
from torch import nn
from d2l import torch as d2l

def nin_block(in_channels,out_channels,kernel_size,strides,padding):
	return nn.Sequntial(
		nn.Conv2d(in_channels,out_channels,kernel_size,strides,padding),nn.ReLU(),
		# 2个out_channels保持输入输出不变
		nn.Conv2d(out_channels,out_channels,kernel_size=1),nn.ReLU(),
		nn.Conv2d(out_channels,out_channels,kernel_size=1),nn.ReLU()
	)
NiN模型
NiN完全取消了全连接层,相反使用1个NiN块
最后使用1个全局平均池化层,生成1个logits
net = nn.Sequential(
	nin_block(1,96,kernel_size=11,strides=4,padding=0),
	nn.MaxPool2d(3,stride=2),
	nin_block(96,256,kernel_size=5,strides=1,padding=2),
	nn.MaxPool2d(3,stride=2),
	nin_block(256,384,kernel_size=3,stride=1,padding=1),
	nn.MaxPool2d(3,stride=2)
	nn.Dropout(0.5)

	nin_block(384,10,kernel_size=3,strides=1,padding=1),
	nn.AdaptiveAvgPool2d((1,1)),
	nn.Flatten()
)
X = torch.rand(size=(1,1,224,224))
for layer in net:
X = layer(X)
print(layer.__class__.__name__,'output shape:\t',X.shape)训练模型
lr,num_epoches,batch_size=0.1,10,128
train_iter,test_iter = d2l.load_data_fashion_mnist(batch_size,resize=224)
d2l.train_ch6(net,train_iter,test_iter,num_epoches,lr,d2l.try_gpu())
Practice:
-
调整NiN的超参数,以提高分类准确性。
-
为什么NiN块中有两个卷积层?删除其中一个,然后观察和分析实验现象。
-
计算NiN的资源使用情况。
-
参数的数量是多少?
-
计算量是多少?
-
训练期间需要多少显存?
-
预测期间需要多少显存?
-
-
一次性直接将的表示缩减为的表示,会存在哪些问题?