
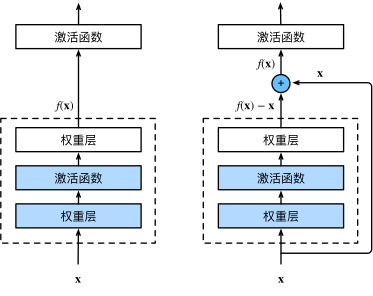
神经网络 = 一个函数集合 网络越大 ↓ 能表示的函数越多 ↓ 函数类扩大 但是: 大网络不一定容易训练 因为: 优化困难 所以ResNet提出: 让新增层学习“残差” 而不是重新学习完整函数
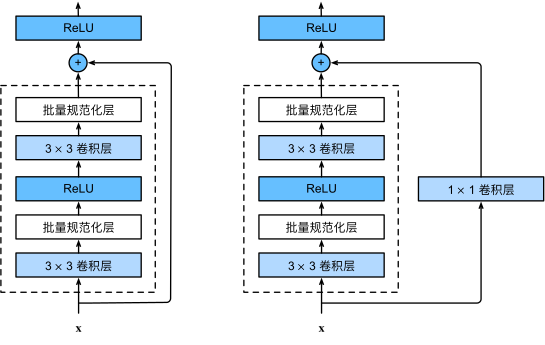
残差块
import torch
from torch import nn
from torch.nn import fucntional as F

class Residual(nn.Module):
	def __init__(self,input_channels,num_channels,use_1x1conv=False,strides=1):
		super().__init__()
		self.conv1 = nn.Conv2d(input_channels,num_channels,kernel_size=3,padding=1,stride=strides)
		self.conv2 - nn.Conv2d(num_channels,num_channels,kernel_size=1,stride=strides)
		if use_1x1conv:
			self.conv3 = nn.Conv2d(input_channels,num_channels,kernel_size=1,stride=strides)
		else:
			self.conv3 = None
		self.bn1 = nn.BatchNorm2d(num_channels)
		self.bn2 = nn.BatchNorm2d(num_channels)

	def forward(self,X):
		Y = F.relu(self.bn1(self.conv1(X)))
		Y = self.bn2(self.conv(Y))
		if self.conv3:
			X = self.conv3(X)
		Y += X
		return F.relu(Y)
blk = Residual(3,3)
X = torch.rand(4,3,6,6)
Y = blk(X)
Y.shape
blk = Residual(3,6,use_1x1conv=True,strides=2)
blk(X).shapeResNet模型
ResNet在每个卷积层后加了批量规范化层
bl = nn.Sequential(nn.Conv(1,64,kernel_size=7,stride=2,padding=3),
nn.BatchNorm2d(64),nn.ReLU(),
nn.MaxPool2d(kernel_szie=3,stride=2,padding=1))
def resnet_block(input_channels,num_channels,num_residuals,first_block=False):
blk = []
for i in range(num_residuals):
if i==0 and not first_block:
blk.append(Residual(input_channels,num_channels.use_1x1conv=True,strides=2))
else:
blk.append(Residual(num_channels,num_channels))
return blk加入4个残差块
b2 = nn.Sequential(*resnet_block(64,64,2,first_block=True))
b3 = nn.Sequential(*resnet_block(64,128,2))
b4 = nn.Sequential(*resnet_block(128,256,2))
b5 = nn.Sequential(*resnet_block(256,512,2))
net = nn.Sequential(b1,b2,b3,b4,b5,nn.AdaptiveAvgPool2d((1,1)),nn.Flatten(),nn.Linear(512,10))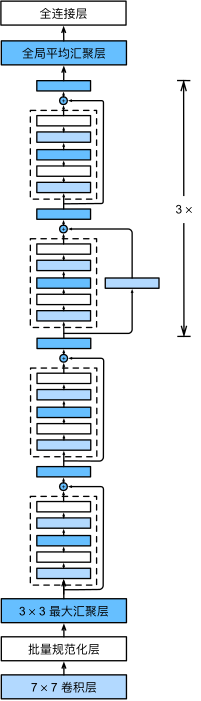
X = torch.rand(size=(1,1,224,224))
for layer in net:
	X = layer(X)
	print(layer.__class__.__name__,'output shape:\t',X.shape)
训练模型
lr,num_epoches,batch_size=0.05,10,256
train_iter,test_iter = d2l.load_data_fashion_mnist(batch_size,resize=96)
d2l.train_ch6(net,train_iter,test_iter,num_epoches,lr,d2l.try_gpu())
Practice:
-
图7.4.1中的Inception块与残差块之间的主要区别是什么?在删除了Inception块中的一些路径之后,它们是如何相互关联的?
-
参考ResNet论文 (He et al., 2016)中的表1,以实现不同的变体。
-
对于更深层次的网络,ResNet引入了“bottleneck”架构来降低模型复杂性。请试着去实现它。
-
在ResNet的后续版本中,作者将“卷积层、批量规范化层和激活层”架构更改为“批量规范化层、激活层和卷积层”架构。请尝试做这个改进。详见 (He et al., 2016)中的图1。
-
为什么即使函数类是嵌套的,我们仍然要限制增加函数的复杂性呢?