
汇聚层
最大汇聚层和平均汇聚层
Pooling 更常见的叫法应该是池化层 一般最常见的是最大池化层和平均池化层 同conv kernel一样,从左到右,从上到下的滑动,取最值或者均值
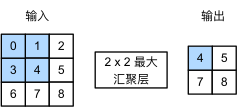
下面实现1个pool2d函数,实现汇聚层的前向传播
import torch
from torch import nn
from d2l import torch as d2l

def pool2d(X,pool_size,mode='max'):
	p_h,p_w=pool_size
	Y=torch.zeros((X.shape[0]-p_h+1),X.shape[1]-p_w+1)
	for i in range(Y.shape[0]):
		for j in range(Y.shape[1]):
			if mode == 'max':
				Y[i,j]=X[i:i+p_h,j:j+p_w].max()
			elif mode == 'avg'
				Y[i,j]=Y[i:i+p_h,j:j+p_w].mean()
	return Y
X = torch.tensor([[0.0,1.0,2.0],[3.0,4.0,5.0],[6.0,7.0,8.0]])
pool2d(X,(2,2))pool2d(X,(2,2),'avg')stride
X = torch.arange(16,dtype=torch.float32).reshape((1,1,4,4))
X默认情况下,pytorch框架下的步幅与池化窗口的大小相同。因此,如果使用形状为(3,3)的池化层,则步幅形状默认(3,3)
pool2d = nn.MaxPool2d(3)
pool2d(X)
填充和步幅可以手动设定
pool2d = nn.MaxPool2d(3,padding=1,stride=2)
pool2d(X)
当然也可以不是正方形
pool2d = nn.MaxPool2d((2,3),stride=(2,3),padding=(0,1))
pool2d(X)
多个通道
池化层在每个输入通道上单独运算,而不是像卷积层一样在通道上对输入进行汇总。
X = torch.cat((X,X+1),1)
#沿着1个已有的维度拼接
X
pool2d = nn.MaxPool2d(3,padding=1,stride=2)
pool2d(X)Practice:
-
尝试将平均汇聚层作为卷积层的特殊情况实现。
-
尝试将最大汇聚层作为卷积层的特殊情况实现。
-
假设汇聚层的输入大小为,则汇聚窗口的形状为,填充为,步幅为。这个汇聚层的计算成本是多少?
-
为什么最大汇聚层和平均汇聚层的工作方式不同?
-
我们是否需要最小汇聚层?可以用已知函数替换它吗?
-
除了平均汇聚层和最大汇聚层,是否有其它函数可以考虑(提示:回想一下
softmax)?为什么它不流行?