
门控隐状态
模型有专门的机制来确定应该何时更新隐状态,以及何时重置隐状态。 这些机制是可学的
重置门和更新门
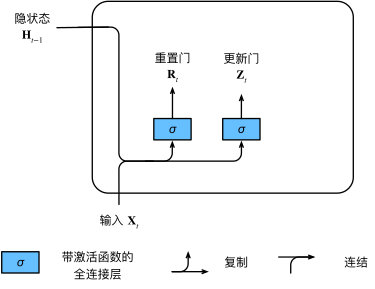
输入是由当前时间步的输入和前一时间步的隐状态给出,两个门的输出是由使用sigmoid激活函数的两个全连接层给出。
候选隐状态
将重置门和常规隐状态更新机制集成,得到在时间步t的候选隐状态
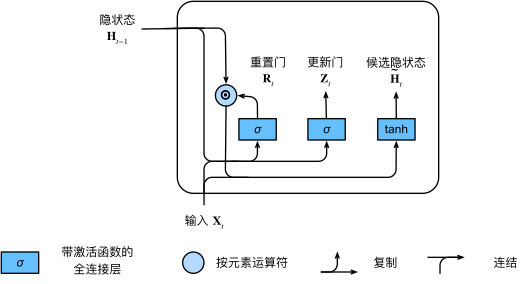
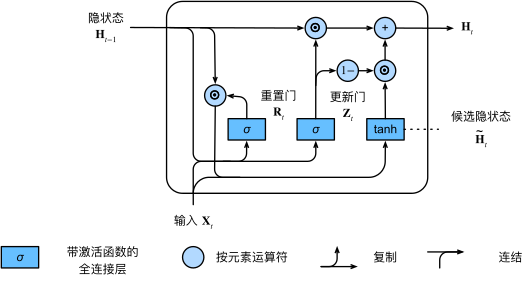
隐状态
接近于1时,模型倾向于只保留旧状态,此时的信息基本被忽略,有效的跳过了依赖链条中的时间步t,相反,接近0时,新的隐状态就会接近候选隐状态.
从0开始实现
import torch
from torch import nn
from d2l import torch as d2l

batch_sizer,num_steps=32,35
train_iter,vocab=d2l.load_data_time_machine(batch_size,num_steps)
初始化模型参数
def get_params(vocab_size,num_hiddens,device):
	num_inputs = num_outputs = vocab_size

	def normal(shape):
		return torch.random(size=shape,device=device)*0.01
	def three():
		return (normal((num_input,num_hiddens)),
				normal((num_hiddens,num_hiddens)),
				torch.zeros(num_hiddens,device=device)
				)
	W_xz,W_hz,b_z = three()
	W_xr,W_hr,b_r = three()
	W_xh,W_hh,b_h = three()

	W_hq = normal((num_hiddens,num_outputs))
	b_q = torch.zeros(num_outputs,device=device)

	params = [W_xz,W_hz,b_z,W_xr,W_hr,b_r,W_xh,W_hh,b_h,W_hq,b_q]
	for param in params:
		param.requires_grad_(True)
	return params
定义模型
def init_gru_state(batch_size,num_hiddens,device):
	return (torch.zeros((batch_size,num_hiddens),device=device),)
def gru(inputs,state,params):
W_xz,W_hz,b_z,W_xr,W_hr,b_r,W_xh,W_hh,b_h,W_hq,b_q = params
H,=state
outputs = []
for X in inputs:
Z = torch.sigmoid((X@W_xz)+(H@W_hz)+b_z)
R = torch.sigmoid((X@W_xr)+(H@W_hr)+b_r)
H_tilda = torch.tanh((X@W_xh)+((R*H)@W_hh)+b_h)
H = Z*H+(1-Z)*H_tilda
Y=H@W_hq+b_q
outputs.append(Y)
return torch.cat(outputs,dim=0),(H,)训练与预测
vocab_size,num_hiddens,device = len(vocab),256,d2l.try_gru()
num_epoches,lr=500,1
model = d2l.RNNModelScratch(len(vocab),num_hiddens,device,get_params,init_gru_state,gru)
d2l.train_ch8(model,train_iter,vocab,lr,num_epochs,device)
简介实现
num_inputs = vocab_size
gru_layer = nn.GRU(num_inputs,num_hiddens)
model = d2l.RNNModel(gru_layer,len(vocab))
model = model.to(device)
d2l.train_ch8(model,train_iter,vocab,lr,num_epochs,device)
Practice:
-
假设我们只想使用时间步的输入来预测时间步的输出。对于每个时间步,重置门和更新门的最佳值是什么?
-
调整和分析超参数对运行时间、困惑度和输出顺序的影响。
-
比较
rnn.RNN和rnn.GRU的不同实现对运行时间、困惑度和输出字符串的影响。 -
如果仅仅实现门控循环单元的一部分,例如,只有一个重置门或一个更新门会怎样?