
无隐状态的神经网络
看看只有但隐藏层的MLP,设隐藏层的激活函数为,给定1个小批量样本,其中批量大小为,输入维度为,则激活函数的输出则有:
我们拥有的隐藏层权重参数为,偏置参数,以及隐藏单元的数目为h,因此求和时可以应用广播机制。接下来,将隐藏变量作为输出层的输入,输出层由下式给出:
有隐状态的循环神经网络
当前时间步隐藏变量由当前时间步的输入与前一个时间步的隐藏变量一起计算得出:
捕捉并保留了序列直到当前时间步的历史信息。 由于在当前时间步中,隐状态使用的定义与前一个是按步中使用的隐状态定义相同,因此计算是循环的。于是基于循环计算的隐状态神经网络被命名为循环神经网络recurrent netural network,循环神经网络中执行计算的层被称为循环层 有许多不同的方法可以狗i教案循环神经网络,对于时间步,输出层的输出类似于MLP中的计算
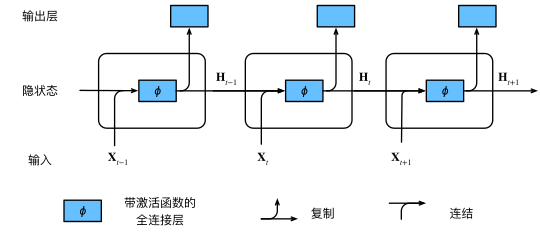
- 隐状态的计算: 拼接当前时间步的输入和前一时间步t-1的隐状态
- 将拼接的结果送入带有激活函数的全连接层,全连接层的输出是当前时间步t的隐状态
import torch
from d2l import torch as torch
X,W_xh = torch.normal(0,1,(3,1)),torch.normal(0,1,(1,4))
H,W_hh = torch.normal(0,1,(3,4)),torch.noraml(0,1,(4,4))
torch.matmul(X,W_xh)+torch.matmul(H,W_hh)

torch.matmul(torch.cat(X,H),1),torch.cat((W_xh,W_hh),0
基于循环神经网络的字符集语言模型
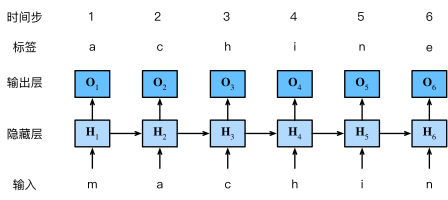
训练过程中,对于每个时间步的输出层的输出进行softmax操作,让后利用交叉熵损失计算模型输出和标签之间的误差
Perplexity(困惑度)
讨论如何度量语言模型的质量,用于评估模型
通过一个序列中所有的n个词元的交叉熵损失的平均值来衡量 困惑度最好的理解是下一个次元的实际选择数的调和平均数
Practice:
-
如果我们使用循环神经网络来预测文本序列中的下一个字符,那么任意输出所需的维度是多少?
-
为什么循环神经网络可以基于文本序列中所有先前的词元,在某个时间步表示当前词元的条件概率?
-
如果基于一个长序列进行反向传播,梯度会发生什么状况?
-
与本节中描述的语言模型相关的问题有哪些?