
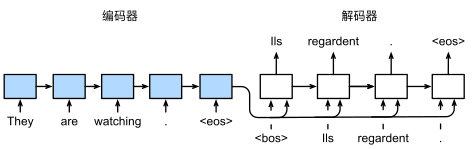
机翻输入输出 DNA序列转3d 都是比较常见的Seq2Seq问题 采用Decoder-Encoder架构
import collections
import math
import torch
from torch import nn
from d2l import torch as d2l
Decoder
将长度可变的输入序列转换为形状可变的上下文变量,并将输入序列的信息在该上下文变量中编码
使用了Embedding Layer来获取输入序列中的每个词元的特征向量,嵌入层的权重是一个矩阵,行数等于vocab_size,列数等于特征向量的维度embed_size,本文选择1个多层GRU来实现编码器
class Seq2SeqEncoder(d2l.Encoder):
	def __init__(self,vocab_size,embed_size,num_hiddens,num_layers,dropout=0,**kwargs):
	super(Seq2SeqEnoder,self).__init__(**kwargs)
	self.embedding = nn.Embedding(vocab_size,embed_size)
	self.rnn = nn.GRU(embed_size,num_hiddens,num_layers,dropout=dropout)
	def forward(self,X,*args):
		X = self.embedding(X)
		X = X.permute(1,0,2)
		output,state = self.rnn(X)
		return output,state
下面实例化编码器的实现:使用1个2层GRU,隐藏单元数等于16,给定一个小批量的输入序列X,完成了所有的时间步后,最后1层的隐状态的输出是1个张量,形状为(时间步数,批量大小,隐藏单元数)
encoder = Seq2SeqEncoder(vocab_size=10,embed_size=8,num_hiddens=16,num_layers=2)
encoder.eval()
X = torch.zeros((4,7),dtype=torch.long)
output,state = encoder(X)
output.shape
Decoder
编码器输出的上下文变量对整个输入序列进行编码,解码器输出的概率取决于先前的输出子序列和上下文变量,即 使用另一个RNN作为解码器,输出序列上的任意时间步,在当前时间步将它们和上衣隐状态转换为隐状态,使用函数表示解码器的隐藏层的变换: 获得解码器的隐状态后,使用输出层和softmax操作计算时间步输出的条件概率
class Seq2SeqDecoder(nn.Module):
	def __init__(self,vocab_size,embed_size,num_hiddens,num_layers,dropout=0,**kwargs):
		super(Seq2SeqDecoder,self).__init__(**kwargs)
		self.embedding = nn.Embedding(vocab_size,embed_size)
		self.rnn=nn.GRU(embed_size+num_hiddens,num_hiddens,num_layers,dropout=dropout)
		self.dense=nn.Linear(num_hiddens,vocab_size)
	def init_state(self,enc_outputs,*args):
		return enc_outputs[1]
	def forward(self,X,state):
		X = self.embedding(X).permate(1,0,2)
		context = state[-1].repeat(X.shape[0],1,1)
		X_and_context = torch.cat((X,context),2)
		output,state=self.rnn(X_and_context,state)
		output = self.dense(output).permute(1,0,2)

		return output,state
decoder = Seq2SeqDecoder(vocab_size=10,embed_size=8,num_hiddens=16,num_layers=2)
decoder.eval()
state=decoder.init_state(encoder(X))
output,state = decoder(X,state)
output.shape,state.shapeLoss Function
def sequence_mask(X,valid_len,value=0):
	maxlen = X.size(1)
	mask = torch.arange((maxlen),dtype=torch.float32,device=X.device)[Nonem:]<valid_len[:,None]
	X[~mask]=value
	return X
X = torch.tensor([[1,2,3],[4,5,6]])
sequence_mask(X,torch.tensor([1,2]))
X = torch.ones(2,3,4)
sequence_mask(X,torch.tensor([1,2]),value=-1)通过拓展softmax交叉熵损失函数来遮蔽不相关的预测
class ModuleSoftmaxCELoss(nn.CrossEntropyLoss):
	def forward(self,pred,label,yalid_len):
		weights = torch.ones_like(label)
		weights = sequence_mask(weights,valid_len)
		self.reduction='none'
		unweighted_loss = super(MaskedSoftmaxCELoss,self).forward(pred.permute(0,2,1),label)
		weighted_loss = (unweighted_loss*weights).mean(dim=1)
		return weighted_loss
loss = MaskedSoftmaxCELoss()
loss(torch.ones(3,4,10),torch.ones((3,4),dtype=torch.long),torch.tensor([4,2,0]))Train
def train_seq2seq(net,date_iter,lr,num_epochs,tgt_vocab,device):
	def xavier_init_weights(m):
		if type(m)==nn.Linear:
			nn.init.xavier_uniform_(m.weight)
		if type(m)==nn.GRU:
			for param in m._flat_weights_names:
				if "weight" in param:
					nn.init.xavier_uniform_(m._parameters[param])
	net.apply(xavier_init_weights)
	net.to(device)
	optimizer = torch.optim.Adama(net.parameters(),lr=lr)
	loss = MaskedSoftmaxCELoss()
	net.train()
	animator=d2l.Animator(xlabel='epoch',ylabel='loss',xlim=[10,num_epoches])
	for epoch in range(num_epochs):
		timer = d2l.Timer()
		metric = d2l.Accumulator(2)
		for batch in data_iter:
			optimizer.zero_grad()
			X,X_valid_len,Y,Y_valid_len = [x.to(device)for x in batch]
			bos = torch.tensor([tgt_vocab['<bos>']]*Y.shape[0],device=deice).reshape(-1,1)
			dec_input = torch.cat([bos,Y[:,:-1]],1)
			Y_hat,_ = net(X,dec_input,X_valid_len)
			l = loss(Y_hat,Y,Y_valid_len)
			l.sum().backward()
			d2l.grad_clipping(net,1)
			num_tokens = Y_valid_len.sum()
			optimizer.step()
			with torch.no_grad():
				metric.add(l.sum(),num_tokens)
		if (epoch+1)%10==0:
			animator.add(epoch+1,(metric[0]/metric[1],))
	print(f'loss{metric[0]/metric[1]:.3f},{metric[1]/timer.stop():.1f}' f'tokens/sec on {str(device)}')
embed_size,num_hiddens,num_layers,dropout = 32,32,2,0.1
batch_size,num_steps = 64,10
lr,num_epochs,device = 0.005,300,d2l.try_gpu()
train_iter,src_vocab,tgt_vocab = d2l.load_data_nmt(batch_size,num_steps)
encoder = Seq2SeqEncoder(len(src_vocab),embed_size,num_hiddens,num_layers,dropout)
Seq2SeqDecoder(len(tgt_vocab),embed_size,num_hiddens,num_layers,dropout)
net = d2l.EncoderDecoder(encoder,decoder)
train_seq2seq(net,train_iter,lr,num_epochs,tgt_vocab,device)预测
每个编码器当前时间步的输入都将来自于前一时间步的预测词元
def predit_seq2seq(net,src_sentence,src_vocab,tgt_vocab,num_steps,device,save_attention_weights=False)
	net.eval()
	src_tokens = src_vocab[src_sentence.lower().split(' ')]+[src_vocab['<eos>']]
	enc_valid_len = torch.tensor([len(src_tokens)],device=device)
	src_tokens = d2l.truncate_pad(src_tokens,num_steps,src_vocab['<pad>'])
	#添加批量轴
	enc_X = torch.unsqueeze(torch.tensor(src_tokens,dtype=torch.long,device=device),dim=0)
	enc_outputs = net.encoder(enc_X,enc_valid_len)
	dec_state = net.decoder.init_state(enc_outputs,enc_valid_len)
	#添加批量轴
	dec_X = torch.unsequeeze(torch.tensor([tgt_vocab['<bos>']],dtype=torch.long,device=device),dim=0)
	output_seq,attention_weight_seq = [],[]
	for _ in range(num_steps):
		Y,dec_state = net.decoder(dec_X,dec_state)
		dec_X = Y.argmax(dim=2)
		pred = dec_x.sueeze(dim=0).type(torch.int32).item()
		if save_attention_weights:
			attention_weight_seq.append(net.decoder.attention_weights)
		if pred == tgt_vocab['<eos>']
			break
		output_seq.append(pred)
	return ' '.join(tgt_vocab.to_tokens(output_seq)),attention_weight_seq
预测序列的评估
BLUE(bilingual evaluation understudy)
def blue(pred_seq,label_seq,k:
	pred_tokens,label_tokens = pred_seq.split(' '),label_seq.split(' ')
	#长度惩罚
	len_pred,len_label = len(pred_tokens),len(label_tokens)
	score = math.exp(min(0,1=len_label/len_pred))
	for n in range(1,k+1):
		num_matches,label_subs = 0,collections.defalutdict(int)
		for i in range(len_label-n+1):
			label_subs[' '.join(label_tokens[i:i+n])]+=1
		for i in range(len_pred-n+1):
			if label_subs[' '.join(pred_tokens[i:i+n])]>0:
				num_matches +=1
				label_subs[' '.join(pred_tokens[i:i+n])]-=1
		score *= match.pow(num_matches/(len_pred-n+1),math.pow(0.5,n))
	return score