
隐马尔可夫模型中的动态规划
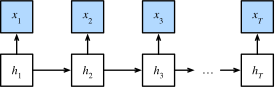
对于有个观测值的序列,在观测状元和隐状态上具有的联合概率分布:
双向模型
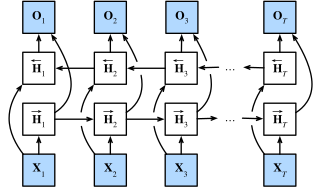
在原本的基础上加一个从最后一个词元开始从后向前运行的循环神经网络
定义
双向RNN计算速度很慢,因为网络的前向传播需要在双向层进行前向和后向递归
双向RNN的错误应用
双向RNN使用了过去和未来的数据,因此不能盲目的将模型应用于任何预测任务,尽管模型产出的困惑度是合理的,比如该模型预测未来词元的能力可能存在巨大缺陷
import torch
from torch import nn
from d2l import torch as d2l

batch_size,num_steps,device=32,35,d2l.try_gpu()
train_iter,vocab = d2l.load_data_time_machine(batch_size,num_steps)
vocab_size,num_hiddens,num_layers=len(vocab),256,2
num_inputs=vocab_size
lstm_layer = nn.LSTM(num_inputs,num_hiddens,num_layers,bidirectional = True)
model = d2l.RNNModel(lstm_layer,len(vocab))
model = model.to(device)
num_epochs,lr=500,1
d2l.train_ch8(model,train_layer,vocab,lr,num_epochs,device)
Practice:
-
如果不同方向使用不同数量的隐藏单位,的形状会发生怎样的变化?
-
设计一个具有多个隐藏层的双向循环神经网络。
-
在自然语言中一词多义很常见。例如,“bank”一词在不同的上下文“i went to the bank to deposit cash”和“i went to the bank to sit down”中有不同的含义。如何设计一个神经网络模型,使其在给定上下文序列和单词的情况下,返回该单词在此上下文中的向量表示?哪种类型的神经网络架构更适合处理一词多义?