
添加更多的隐藏层的RNN
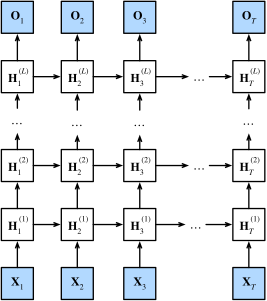
函数依赖关系
输出层的计算仅基于第个隐藏层最终的隐状态:
简介实现
import torch
from torch import nn
from d2l import torch as d2l

batch_size,num_steps = 32,35
train_iter,vocab = d2l.load_data_time_machine(batch_size,num_steps)vocab_size,num_hiddens,num_layers=len(vocab),256,2
num_inputs=vocab_size
device = d2l.try_gpu()
lstm_layer = nn.LSTM(num_inputs,num_hiddens,num_layers)
model = d2l.RNNModel(lstm_layer,len(vocab))
model = model.to(device)训练与预测
num_epochs,lr=500,2
d2l.train_ch8(model,train_iter,vocab,lr*1.0,num_epochs,device)
Practice:
-
基于我们在 8.5节中讨论的单层实现, 尝试从零开始实现两层循环神经网络。
-
在本节训练模型中,比较使用门控循环单元替换长短期记忆网络后模型的精确度和训练速度。
-
如果增加训练数据,能够将困惑度降到多低?
-
在为文本建模时,是否可以将不同作者的源数据合并?有何优劣呢?