
强化学习和监督学习的区别
- superveried learning:
- 输入的数据(标注的数据)应该是没有关联的,因为如果输入的数据有关连,事实上会对learner产生影响
- 需要知道learner正确的标签
- RL:
- 不满足上述条件
- 以
BreakOut游戏为例:上一帧的数据和下一帧的数据之间有很强的连续性
- 强化学习输入的样本是sequence,不是离散的独立的
- learner不知道每一步是否正确,需要自己发现哪些动作可以带来最多的奖励,只能通过不停的尝试来发现最有利的动作
- agent获得能力的过程,事实上是在不断的试错中建立的
- RL过程中,没有很强的supervisor,只有奖励信号(reward signal),且奖励信号是延迟的
一些概念
- 延迟奖励(delayed reward):一般而言,RL中总存在delayed reward
- 标准强化学习和深度强化学习:
- tranditional:需要设计特征提取器完成对某一个feature的提取,类似于ml
- deep RL:通过nn来拟合函数或者策略网络,来完成对特征的提取
- 奖励(reward): 一种标量的反馈信号(sclar feedback signal),可以显示agent在某一步采取某个策略表现如何
- 观测和状态:
- 状态是对世界的完整描述
- 观测是对状态的部分描述,可能会遗漏一些信息
- 部分可观测:agent只能看到部分的视频,这时候,强化学习通常被建模为部分可观测马尔可夫决策过程
- 动作空间:给定环境中,有效动作的集合经常被称之为动作空间(action space):也可能有离散动作空间和连续动作空间
强化学习智能体的组成:
- policy策略
- 价值函数value function
- model模型
policy
- 随机性策略(stochastic policy) 表示当前策略下给定状态,采取动作的概率
- 确定性策略(determeinstic policy) agent直接采取最有可能的动作: 一般情况下,RL一般采取随机性策略
价值函数
是对未来奖励的预测,用于评估状态的好坏,价值函数中有一个折扣因子(discount factor)
还有一种价值函数Q函数:
未来获得的奖励的期望取决于当前的状态金额当前的动作
model
由状态转移概率和奖励函数组成:
- 状态转移概率
- 奖励函数:
有了policy、value ft、model之后就形成一个马尔可夫决策过程 一个例子:
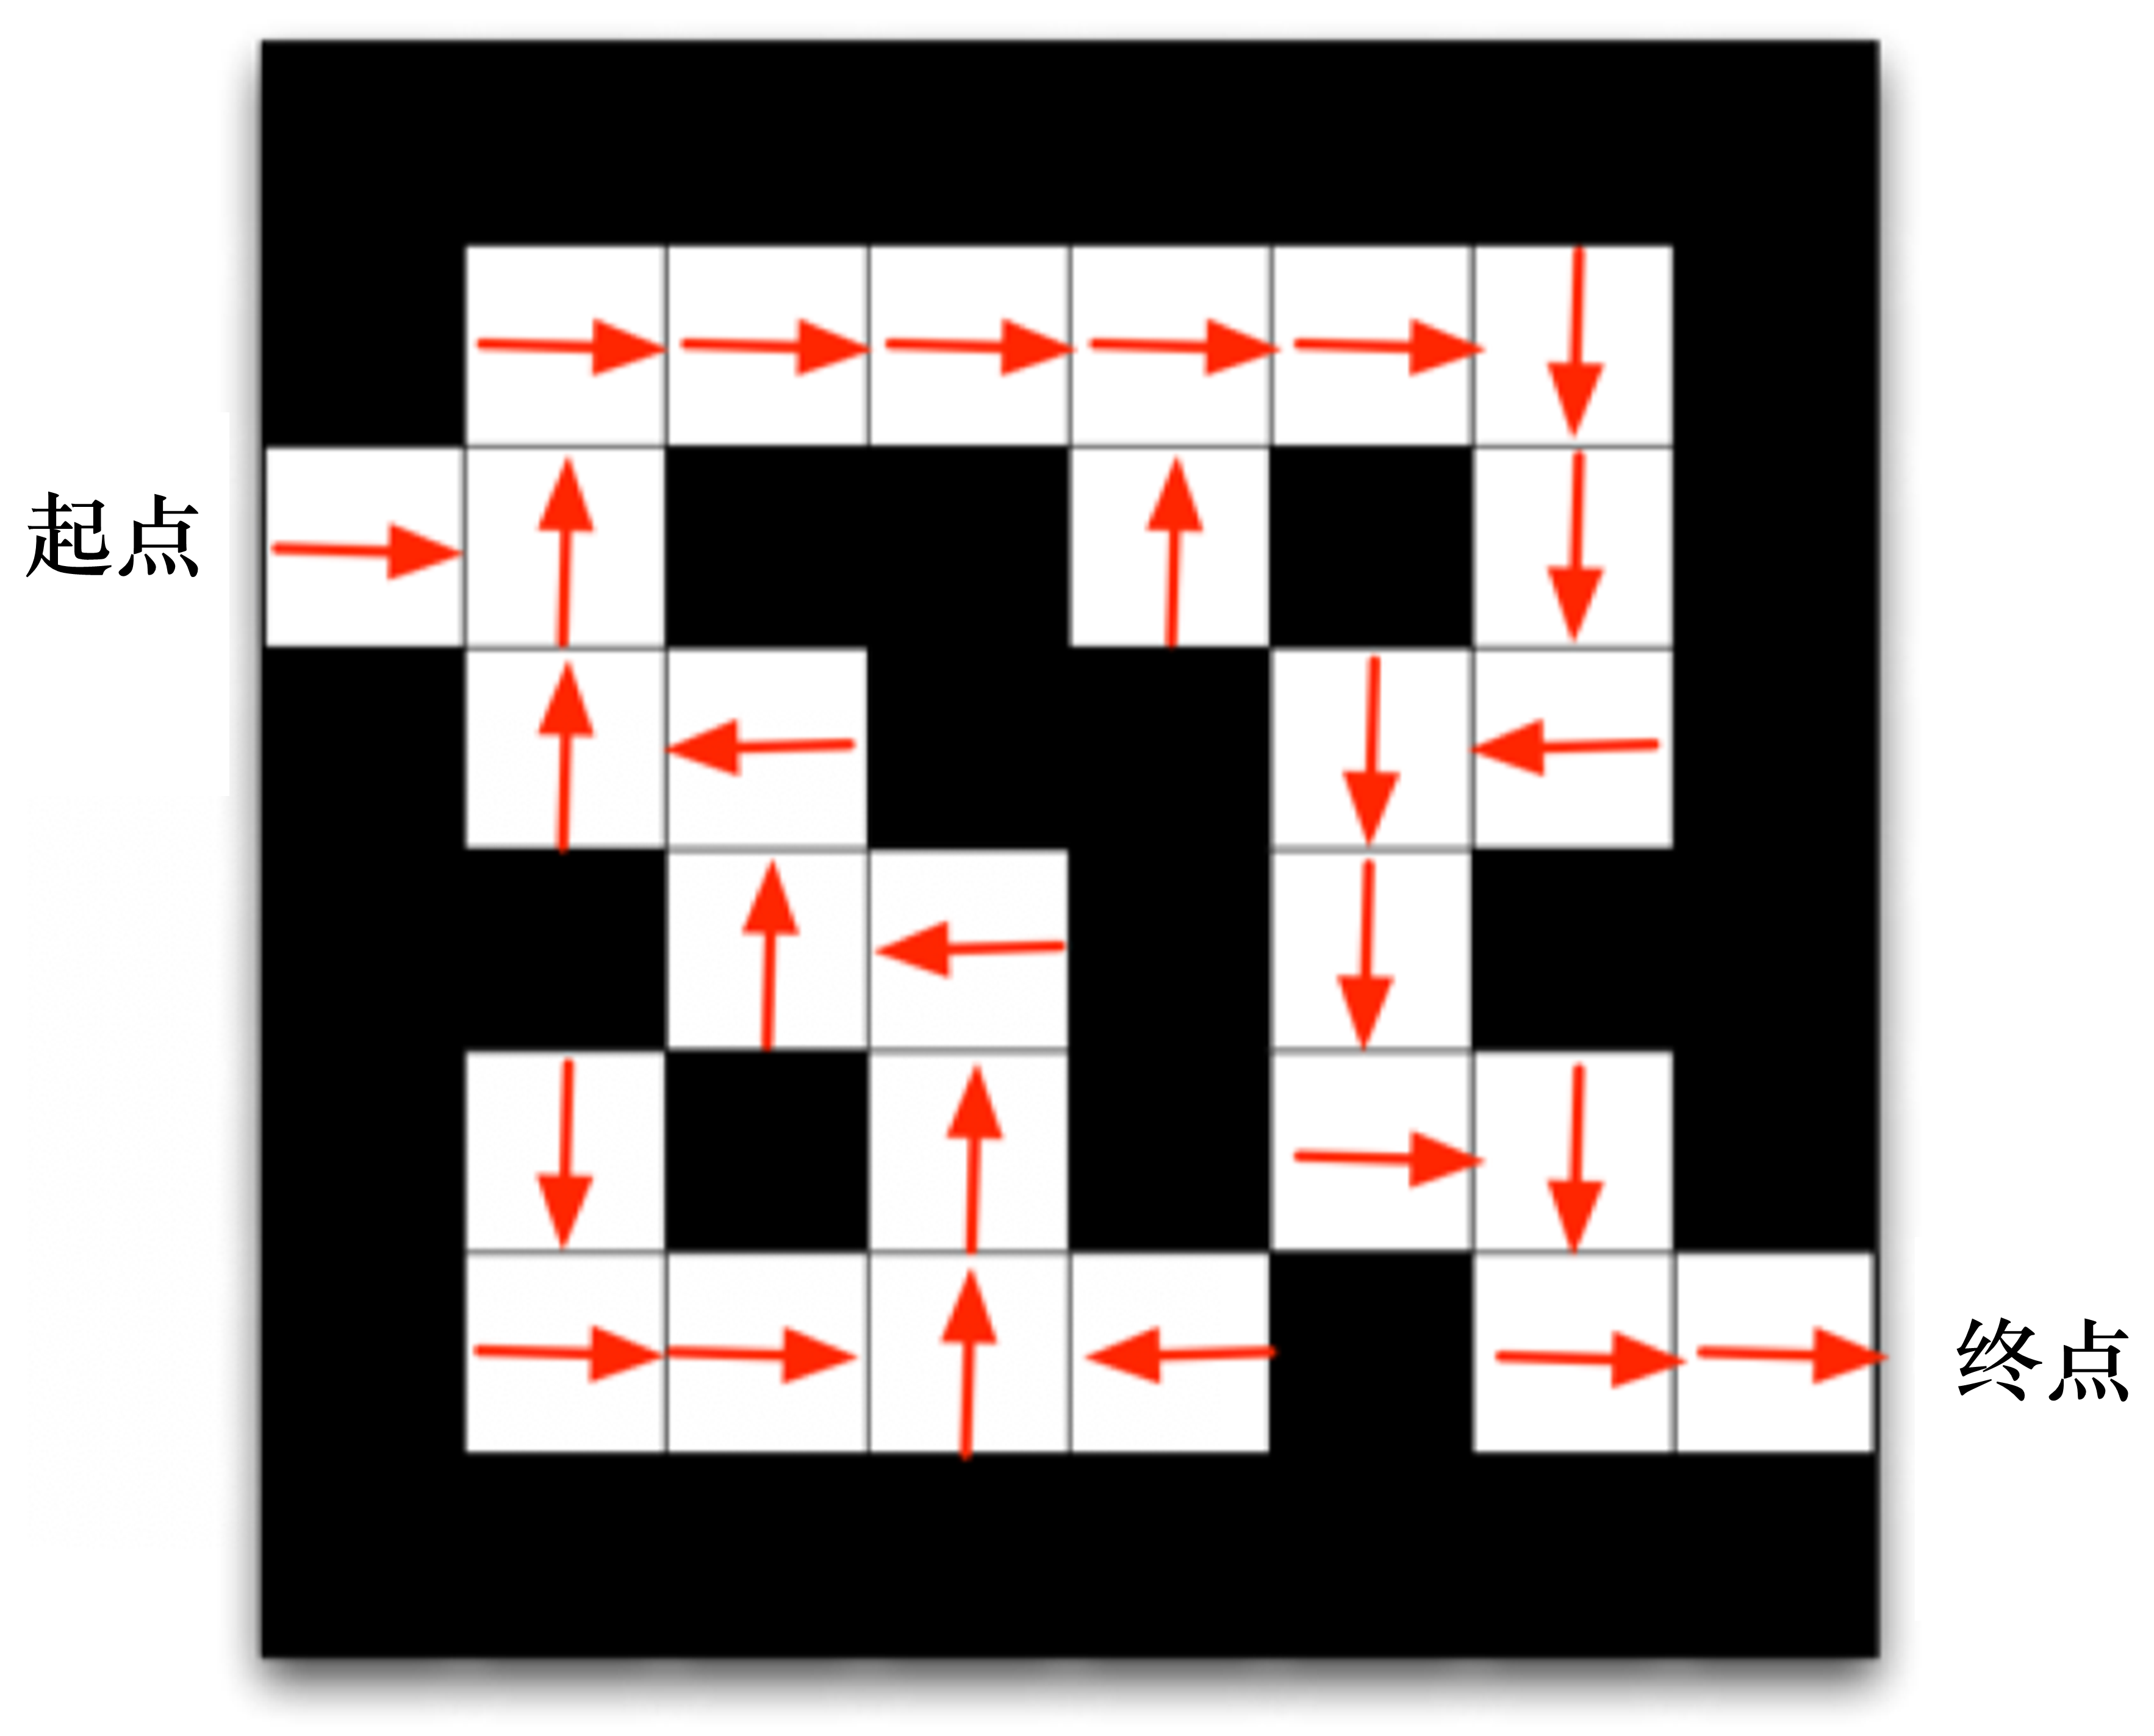
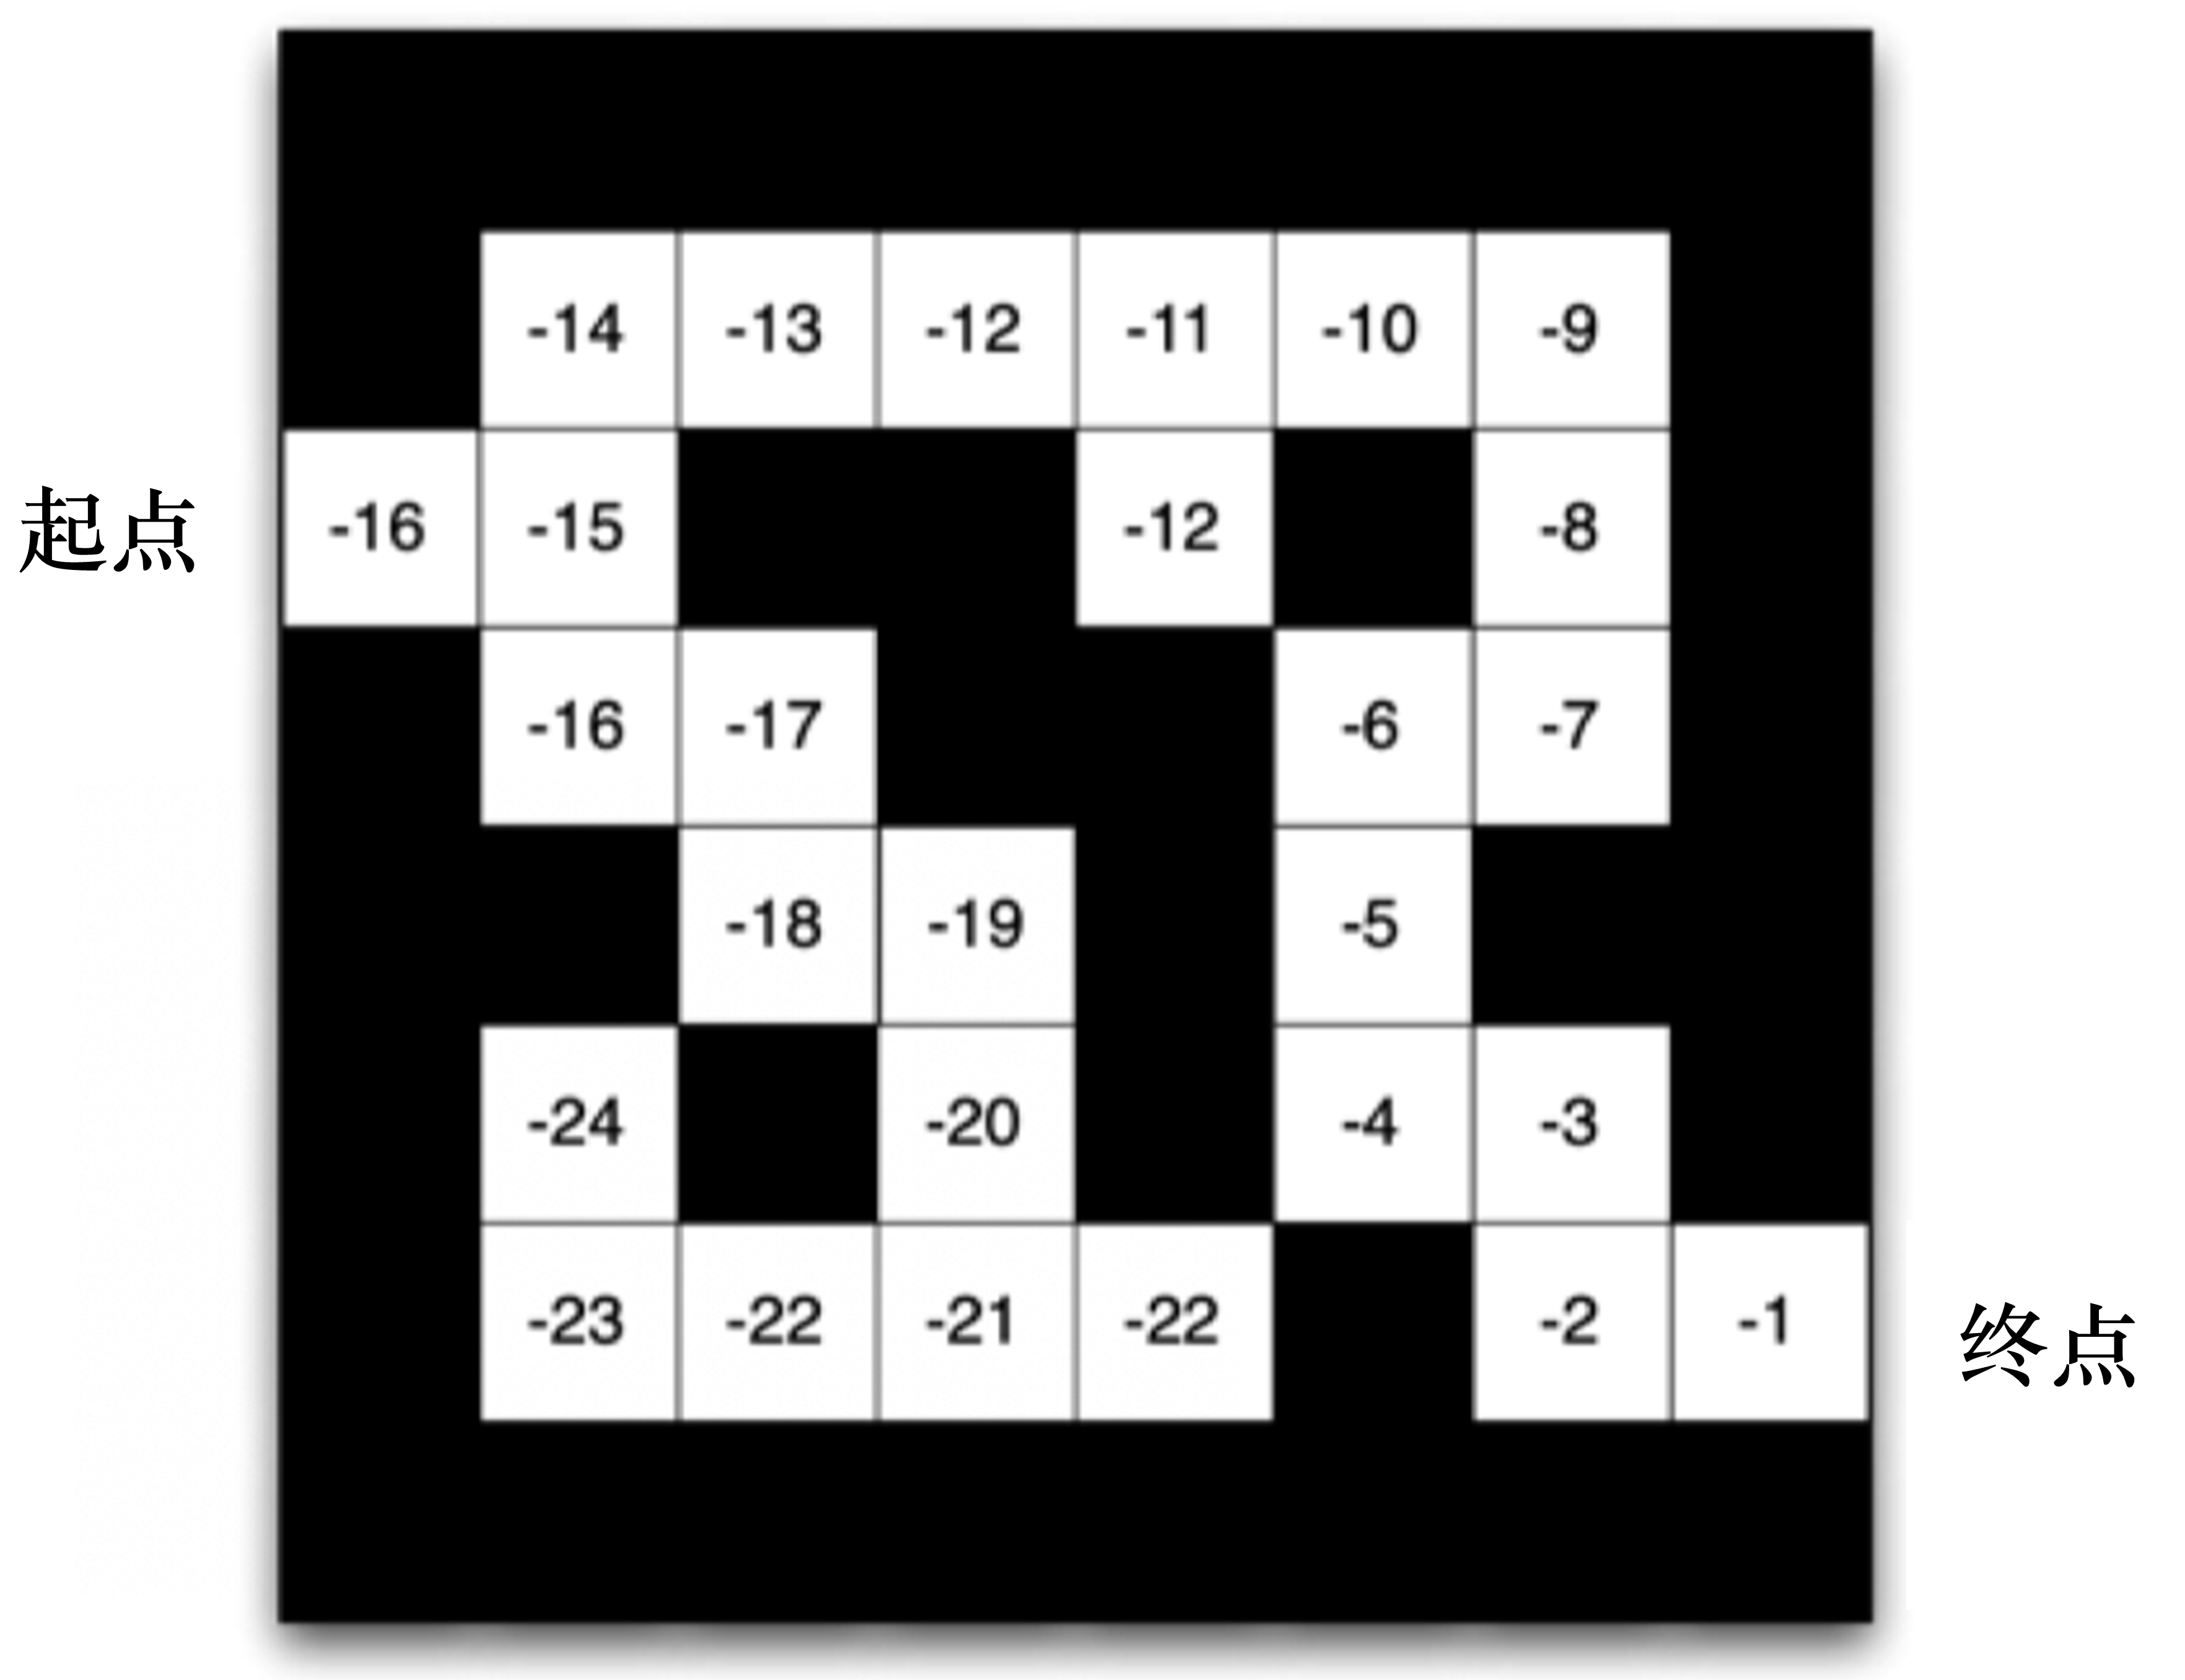
RL agent的类型
- value-based agent & policy-based agent v-bagent显式的学习vf,隐式的学习policy->策略是从value function中推出的; p-b agent直接学习策略,给定一个状态,输出对应动作的概率,并不学习value function 将二者结合起来,就有了actor-criticagent演员-评论员智能体
- model-based agent & model-free agent
- model-based agent:学习状态的转移来采取动作
- model-free agent:不直接估计状态的转移,也不得到环境的具体转移变量,通过学习价值函数和策略函数进行决策.
- 当智能体知道状态转移函数 P(st+1∣st,at)P(st+1∣st,at) 和奖励函数 R(st,at)R(st,at) 后,它就能知道在某一状态下执行某一动作后能带来的奖励和环境的下一状态,这样智能体就不需要在真实环境中采取动作,直接在虚拟世界中学习和规划策略即可。这种学习方法称为有模型强化学习。
- 但是由于转移函数和奖励函数很难估计,环境的状态也是未知的,这时需要model-free agent
学习与规划
- learning
- planning 规划中,环境是已知的,智能体被告知了整个环境的运作规则的详细信息。智能体能够计算出一个完美的模型,且在不需要与环境狡猾的时候进行计算,不需要实时的与环境交互就能知道未来环境,只需要知道当前的状态,就能够开始思考,寻找最优解
探索和利用
- 最大化单步奖励
- K-臂赌博机(K-armed bandit), K臂赌博机有K个摇臂,赌徒在投入一个硬币后选择按下其中一个摇臂,每个摇臂异地顶的概率突出硬币,但这个概率未知 赌徒的目标是最大化这个奖励:即获得最多的硬币 若仅仅为获知每个摇臂的期望奖励,则可采用仅探索法(exploration-only),将所有的尝试机会评分给每个摇臂,最后以每个摇臂各自的平均吐币概率作为其奖励期望的近似;若仅为执行奖励最大的动作,则可采用仅利用法(exploitation-only),按下目前最优的摇臂,若有多个摇臂为最优,则从中随机选取一个 事实上,探索和利用是矛盾的,加强了一方自然会强化另一方,这就是强化学习所面临的探索-利用窘境(exploration-expolitation dilemma),因此如果需要累积奖励最大,必须在探索与利用之间达到较好的折中