
Gym
- 安装Gym库
pip install gym==0.25.2- 安装图形化界面
pip install pygame- 导入Gym库
$python
>>>import gym
以CartPole-v0为例:
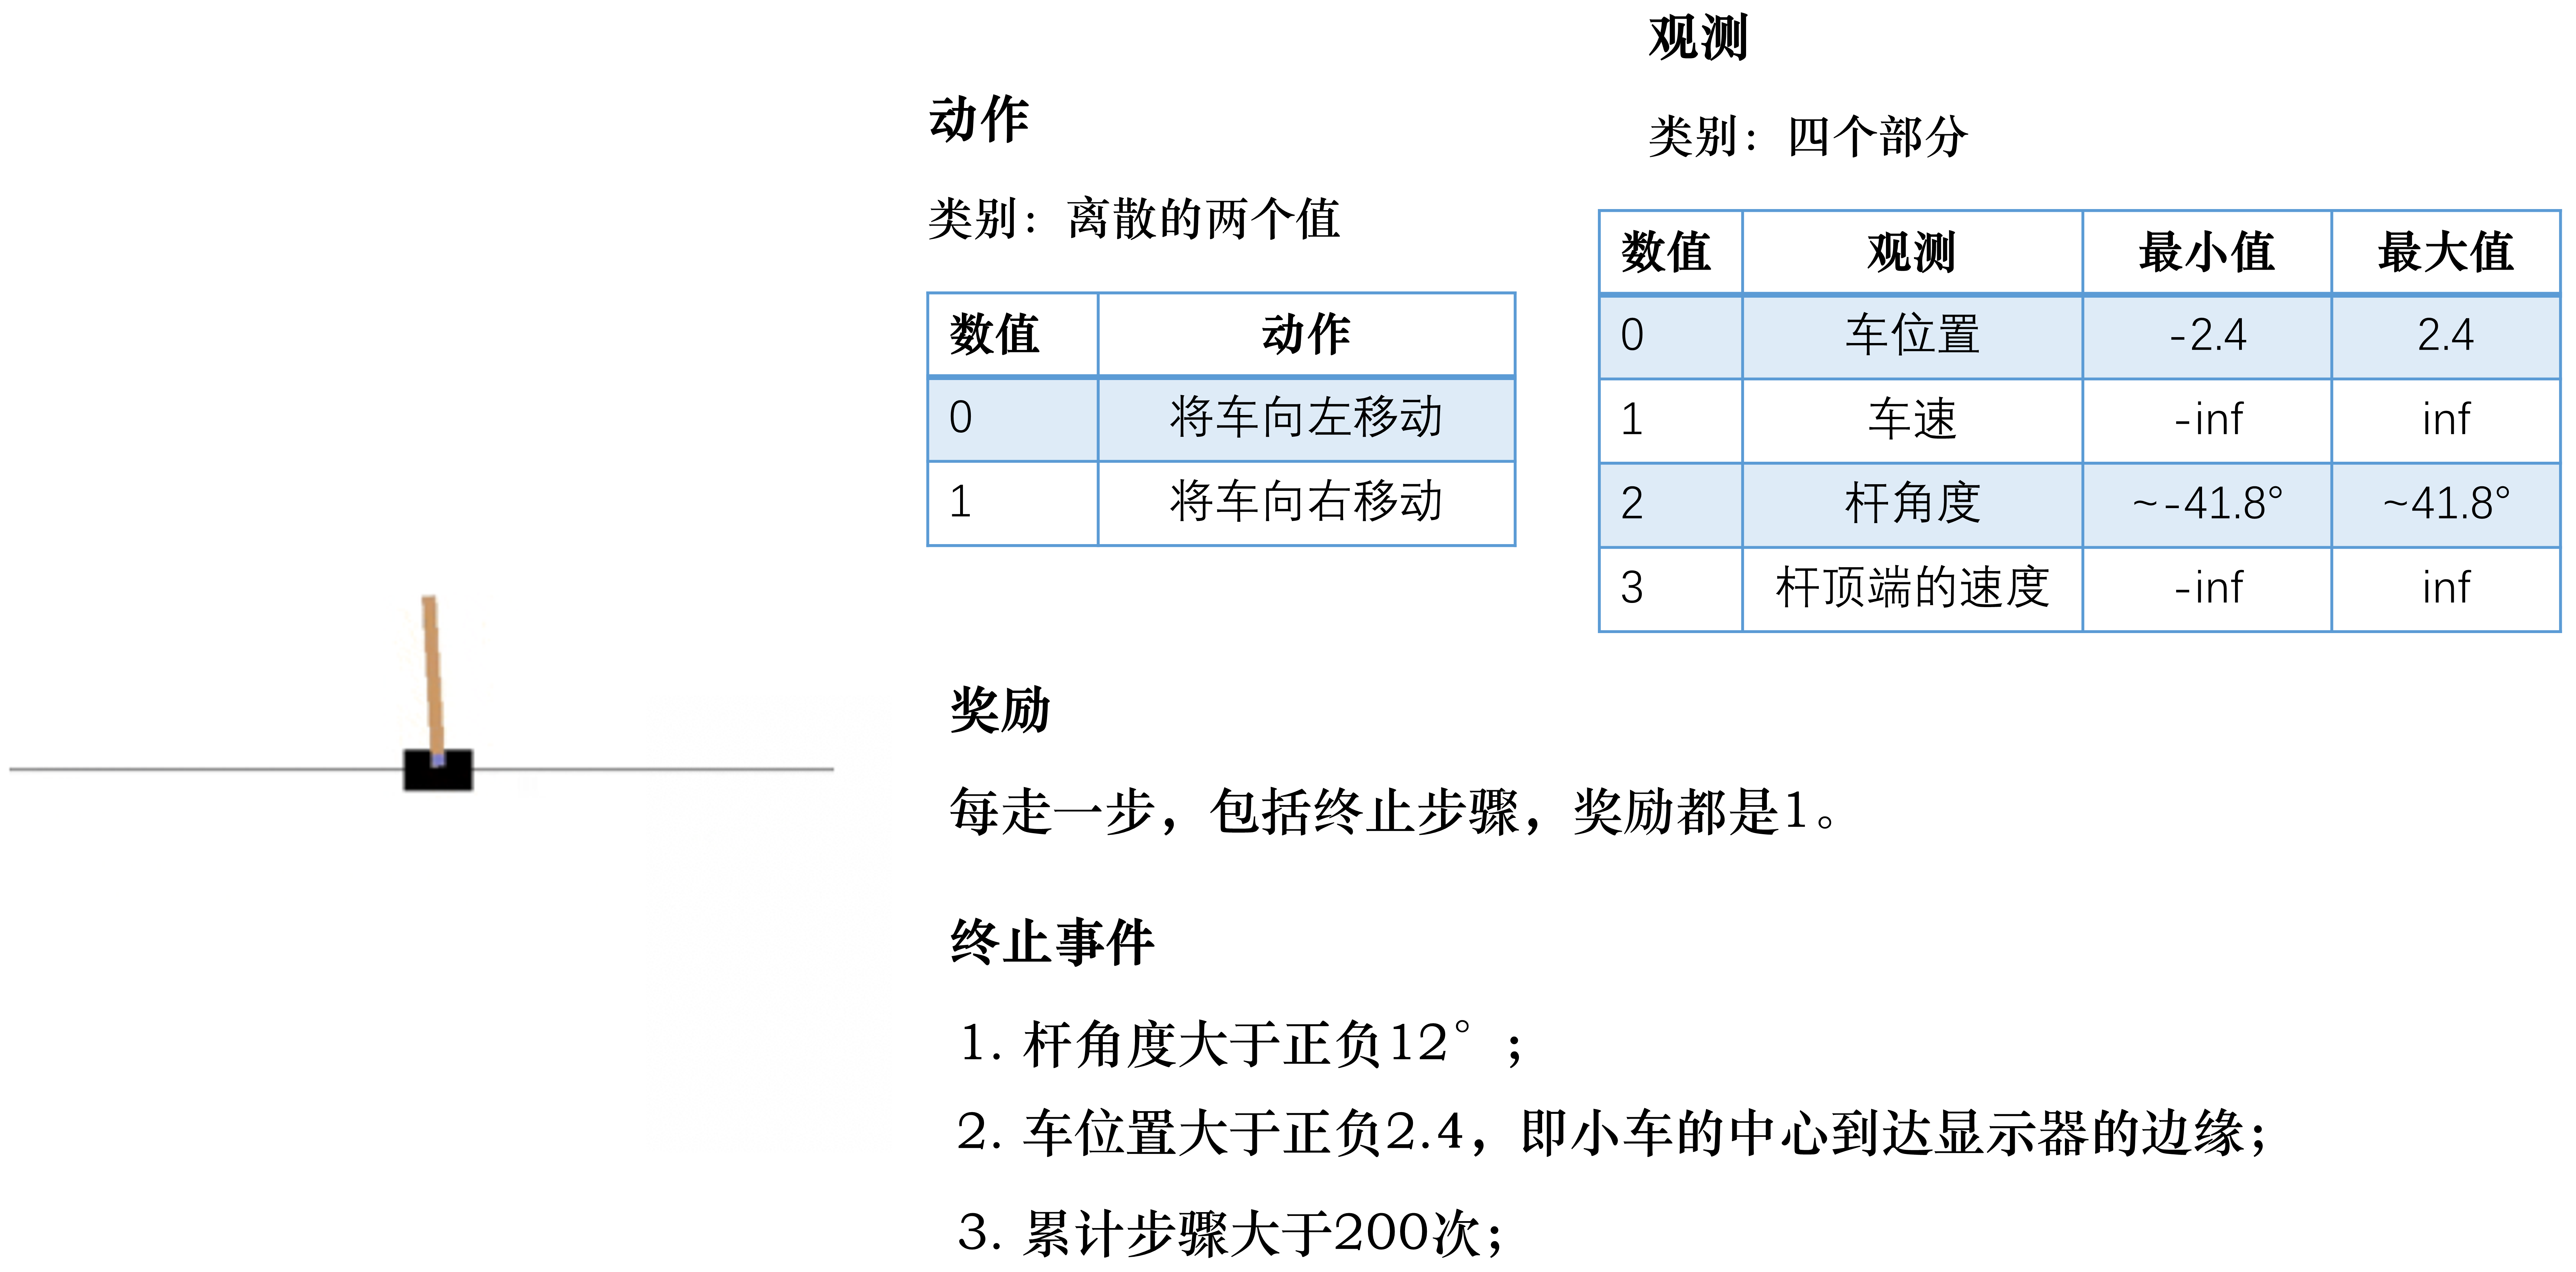
import gym  # 导入 Gym 的 Python 接口环境包
env = gym.make('CartPole-v0')  # 构建实验环境
env.reset()  # 重置一个回合
for _ in range(1000):
    env.render()  # 显示图形界面
    action = env.action_space.sample() # 从动作空间中随机选取一个动作
    env.step(action) # 用于提交动作,括号内是具体的动作
env.close() # 关闭环境Gym库中的大部分小游戏都可以用一个普通的实数或者向量表示,输出env.action_space()的返回值,能看到输出为1或者0。->在该游戏的所有动作空间里随机选择1个作为输出
env.close()有4个返回值:observation,reward,done,info(原始的用于诊断和调试的信息)
每个训练都要使用的返回值有observation,reward,done,但observation的结构会由于游戏的不同变化
import gym
env = gym.make('CartPole-v0')
env.reset()
for _ in range(1000):
	env.reder()n
	action = env.action_space.sample()
	observation,reward,done,info = env.step(action)
	print(observation)
env.close()env.step()完成了一个的过程,不断观察这个过程,并让智能体在其中用相应的算法完成训练,就能得到以1个高质量的强化学习模型
# Gym库已注册的环境可以通过以下代码查看:
from gym import envs
env_specs = envs.registry.all()
envs_ids = [env_spec.id for env_sepc in env_sepcs]
print(env_ids)
MountainCar-v0
来学习如何与Gym库进行交互,选择(MountainCar-v0)作为例子
import gym
env = gym.make('MountainCar-v0')
print('Observation-space={}'.format(env.observation_space))
print('Action-space={}'.format(env.action_space))
print('Observation-range={}'.format(env.observation_space.low,enc.observation_space.high))
print('Action-spaceNums={}'.format(env.action_space.n))Gym库中,环境的观测信息用env.observation_space表示,动作空间用env.action_space表示。
离散的空间用gym.space.Discrete表示,连续空间用gym.space.Box类表示,离散空间用Discrete(n)表示可能取值的数量,对于连续空间,Box类示例成员中的low和high表示每个float的取值范围
MountainCar-v0 中的观测是长度为 2 的 numpy 数组,数组中值的类型为 float。MountainCar-v0 中的动作是整数,取值范围为 {0,1,2}
class SimpleAgent:
	def __init__(self,env):
		pass
	def decide(self,observation):
		position,velocity = observation
		lb = min(-0.09*(position+0.25)**2+0.03,
			0.3*(position+0.9)**4-0.008)
		ub = -0.07*(position+0.38)**2+0.07
		if lb<velocity<ub:
			action = 2
		else:
			action = 0
		return action
	def learn(self,*args):
		pass
agent = SimpleAgent(env)
该智能体不是强化学习智能体,不能学习,只能根据给定的数学表达式进行决策。 下面试图让agent和环境进行交互
def play(env,agent,render=False,train=False):
	episode_reward = 0.
	observation = env.reset()
	while True:
		if render:
			env.render()
		action = agent.decide(observation)
		next_observation,reward,done,_ = env.step(action)

		if train:
			agent.learn(observation,action,reward,done)
		if done:
			break
		observation = next_observation
	return episode_reward
上面代码中的play函数只能让智能体和环境交互一个回合
env是环境类,agent智能体,render用于判断是否需要图形化显示.
if render==True,在交互过程中会调用env.render()显示图形显示,env.close()关闭图形化显示界面
env.seed(3)
episode_reward = play(env,agent,render=True)
print('epoch reward={}'.format(episode_reward))
env.close()
episode_rewards = [play(env,agent) for _ in range(100)]
print('averge reward={}'.format(np.mean(eposide_rewards)))