
basics
multiple GPUs is a single machine/server/node:单机多卡
- 分布式数据并行时:model parameter/optimizer state每张卡都会拷贝一份
- DDP始终在卡间维持着模型参数和优化器参数的同步一致性在整个训练过程中
- DataParallel,batch input通过DistributedSampler split分发到不同的gpus上
- 虽然模型/optimizer相同,但因为数据输入不同,导致loss不同,反向传播计算到的梯度也会不同
- 此时ddp如何保持卡间,model/optimizer 的同步一致性
- ring all-reduce algorithm
Ring AllReduce Algorithm
- 首先将所有的gpu cards连成1个ring
- 同步过程,不需要等待所有的卡都计算完一轮梯度
- 经过这个同步过程之后,所有的卡的models/optimizer 就会保持一致的状态
- Parameter server distributed over all Gpus
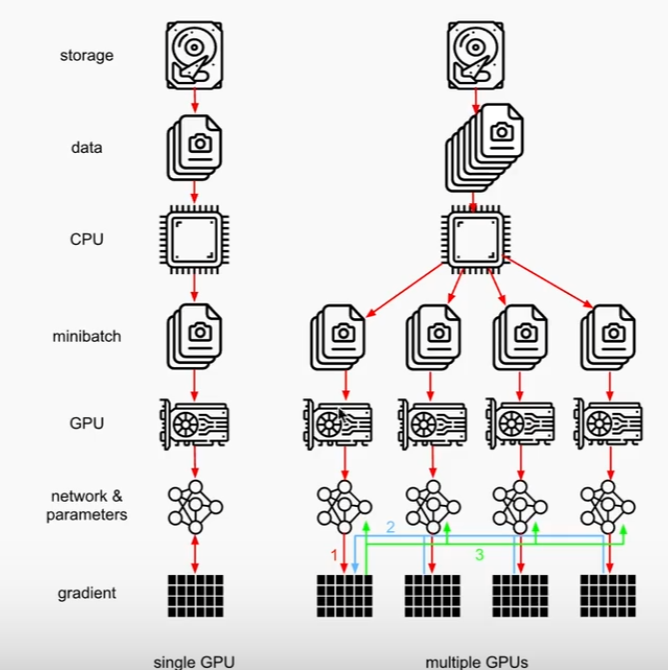
- 计算和同步的几个过程:
- GPus 分别计算损失和梯度
- 梯度的聚合
- 模型/优化器参数的更新和广播
- HPC的基础算法
- Ring环形拓扑结构:
- baidu提出
- 两个过程:
- scatter-reduce
- all gather(broadcast) traditional Algorithm
- send Data to only GPU (reduce)(同上图所示)
- ring Allreduce Algorithm
- SendData 花费的时间将会更少
ddp相关基本概念
node,rank,world_size
- world,world_size: - world:as a group containing all the processes for your distributed training - world内的process可以彼此通信,有ddp分布式训练的
- rank: - rank:is the unique ID given to a process,进程级别的概念、识别进程,因为进程间(process)需要通信 - local rank:is the a unique local ID for processiing running is a single node
- node理解为1个server,2个server就是2个node
- 比如每个node/server各有4张卡(4 gpus),1个2个node/server
- world_size=2*4=8
- ranks = [0,1,2,3,4,5,6,7]
- locak_rank = [0,1,2,3],[4,5,6,7]