
export NCCL_P2P_DISABLE=1:disable direct GPU-to-GPU(P2P)communication- 禁用点对点通信,点对点通信时一种高效的数据传输方式,允许直接在GPU之间传输数据,绕过主机内存
pytorch分布式相关api
torch.distributed.init_process_group()初始化进程组torch.distributed.get_rank(),可以获得当前进程的ranktorch.distributed.get_world_size(),获得进程组的进程数量torch.distributed.barrier(),同步进程组内的所有进程,阻塞所有进程知道所有进程都执行到操作
集合通信
NCCL支持集合通信操作:
Broadcat,进程组内的一个进程及昂Tensor广播给其他进程AllReduce,进程组内的所有进程进行归约操作,最终所有进程得到通道TensorReduceScatter,进程组内所有进程先进行reduce操作,在进行scatter操作,每个进程都得到Tensor的一部分AllGather,进程组内所有进程的Tensor聚合到一个Tensor列表,并且最终所有进程都有1个Tensor列表副本
scatter
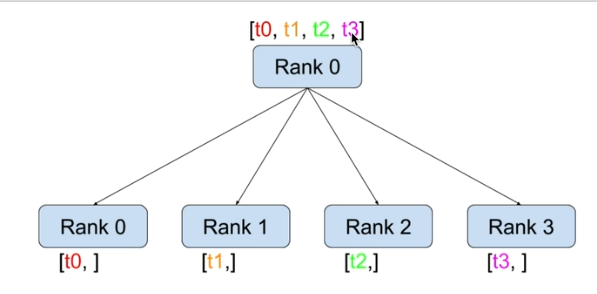
将一个scatter_list拆分到其他节点上
def dist_scatter():
	dist.barrier()

	rank = dist.get_rank()
	world_size = dist.get_world_size()

	tensor = torch.zeros(world_size)
	before_tensor = tensor.clone()
	if dist.get_rank() == 0:
		t_ones = torch.ones(world_size)
		t_fives = torch.ones(world_size)*5
		scatter_list = [t_ones,t_fives]
	else:
		scatter_list = None
	dist.scatter(tensor,scatter_list,src=0)
	logging.info(f"broadcast,rank:{rank},before scatter:{repr(before_tensor)} after scatter:{repr(tensor)}")
gather
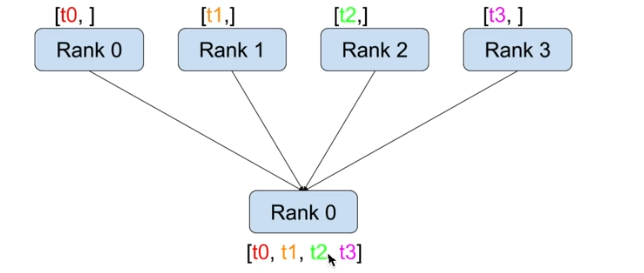
将分散的gather到同一个list中,归到同一个rank
def dist_gather():
	dist.barrier()

	rank = dist.get_rank()
	world_size = ist.get_world_size()

	tensor = torch.tensor([rank*2+1],dtype=torch.float32)
	before_tensor = tensor.clone()

	gather_list = [torch.zeros(1) for _ in range(world_size)]
if rank == 0 else None
		dist.gather(tensor,gather_list,dst=0)#dst=0:聚合到gpu0

		logging_info(f"gather,rank:{rank},before gather:{repr(before_tensor)}after gather:{repr(gather_list)}")
		dist.barrier()
broadcast
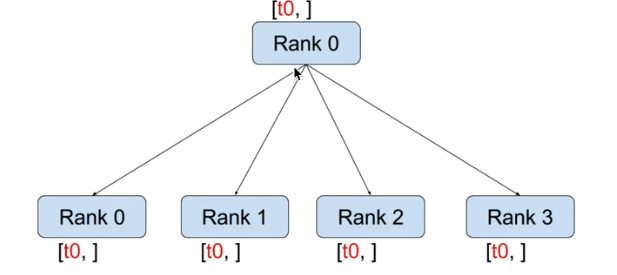
就是简单的传统意义上的广播
def dist_boradcast():
	dist.barrier()

	rank = dist.get_rank()
	world_size = dist.get_world_size()

	src_rank = 0
	tensor = torch.tensor(world_size) if rank == src_rank else torch.zeros(1,dtype=torch.int64)
	before_tensor = tensor.clone()
	dist.broadcast(tensor,src=src_rank)
		logging.info(f"broadcat,rank:{rank},before broadcast tensor:{repr(before_tensor)} after broadcast tensor:{repr(tensor)}")
		dist.barrier()
reduce
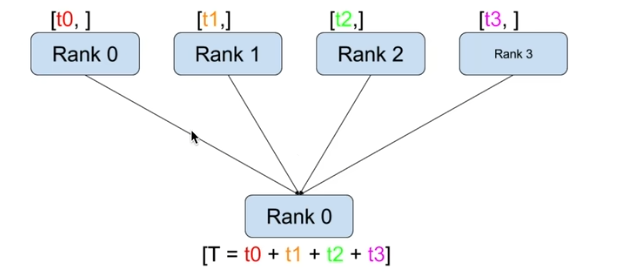
默认的reduce操作时SUM(还可以有MAX,MIN等等操作)
def dist_reduce():
	dist.barrier()

	rank = dist.get_rank()
	world_size = dist.get_world_size()

	tensor = torch.tensor([rank*2+1],dtype=torch.float32)
	before_tensor = tensor.clone()

	dist.reduce(tensor,op=ReduceOp.SUM,dst=0)

	logging.info(f"reduce,rank:{rank},before reduce:{repr(before_tensor)} after reduce:{repr(tensor)}")
	dist.barrier()
all-reduce
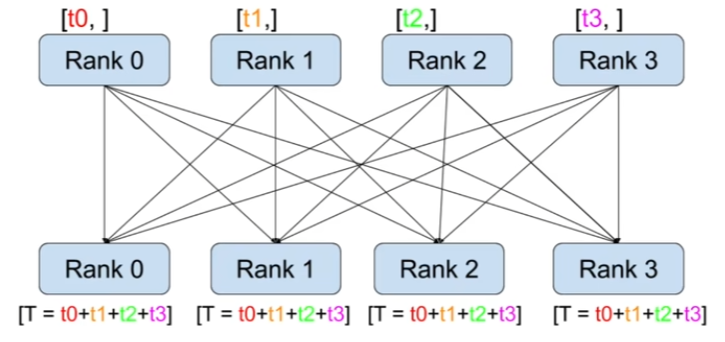
reduce+broadcast
def dist_allreduce():
	dist.barrier()

	rank = dist.get_rank()

	if rank == 0:
		tensor = torch.tensor([1.,2.])
	else:
		tensor = torch.tensor([2.,3.])
	input_tensor = tensor.clone()
	dist.all_reduce(tensor)

	logging.info(f"all_reduce,rank:{rank},before allreduce tensor:{repr{input_tensor}},after allereduce tensor:{repr(tensor)}")

	dist.barrier()
all gather
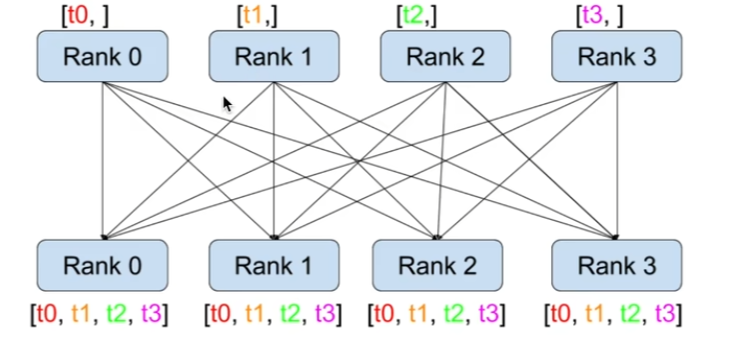
def dist_allgather():
	print_rank_0("allgather:")
	dist.barrier()

	rank = dist.get_rank()
	world_size = dist.get_world_size()

	input_tensor = torch.tensor(rank)
	tensor_list = [torch.zeros(1,dtype=torch.int64) for _ in range(world_size)]
	dist.all_gather(tensor_list,input_tensor)
	logging_info(f"all gather,rank:{rank},input_tensor:{repr(input_tensor)},output tensor_list:{tensor_list}")
	dist.barrier()
reduce-scatter
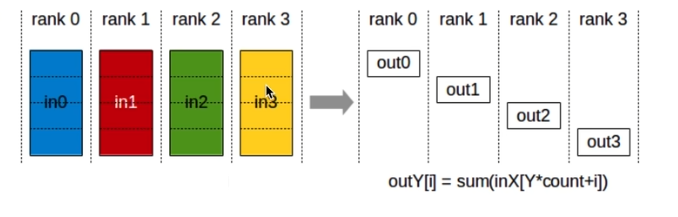
先reduce再scatter
def dist_reducescatter():
	dist.barrier()

	rank = dist.get_rank()
	world_size = dist.get_world_size()

	output = torch.empty(1,dtype=torch.int64)
	input_list = [torch.tensor(rank*2+1),torch.tensor(rank*2+1)]
	dist.reduce_scatter(output,input_list,op=ReduceOp.SUM)
	dist.barrier()
	logging.info(f"reduce_scatter,rank:{rank},input_list:{input_list},tensor:{repr(output)}")
	dist.barrier()