点对点通信,集合通信
import torch.multiprocessing as mp
dist.init_process_group
- 分布式进程组(distributed progress group)
- 主节点:master node;localhost 是pc本机
- MASTER_ADDR/MASTER_PORT:设置主节点的地址与端口号,主要用于分布式的管理
- 单机(单节点)多卡,也是需要显式的设置:每个process如何找到多节点
- 单机多卡,2个process,每个process都会调用init_process来初始化分布式环境
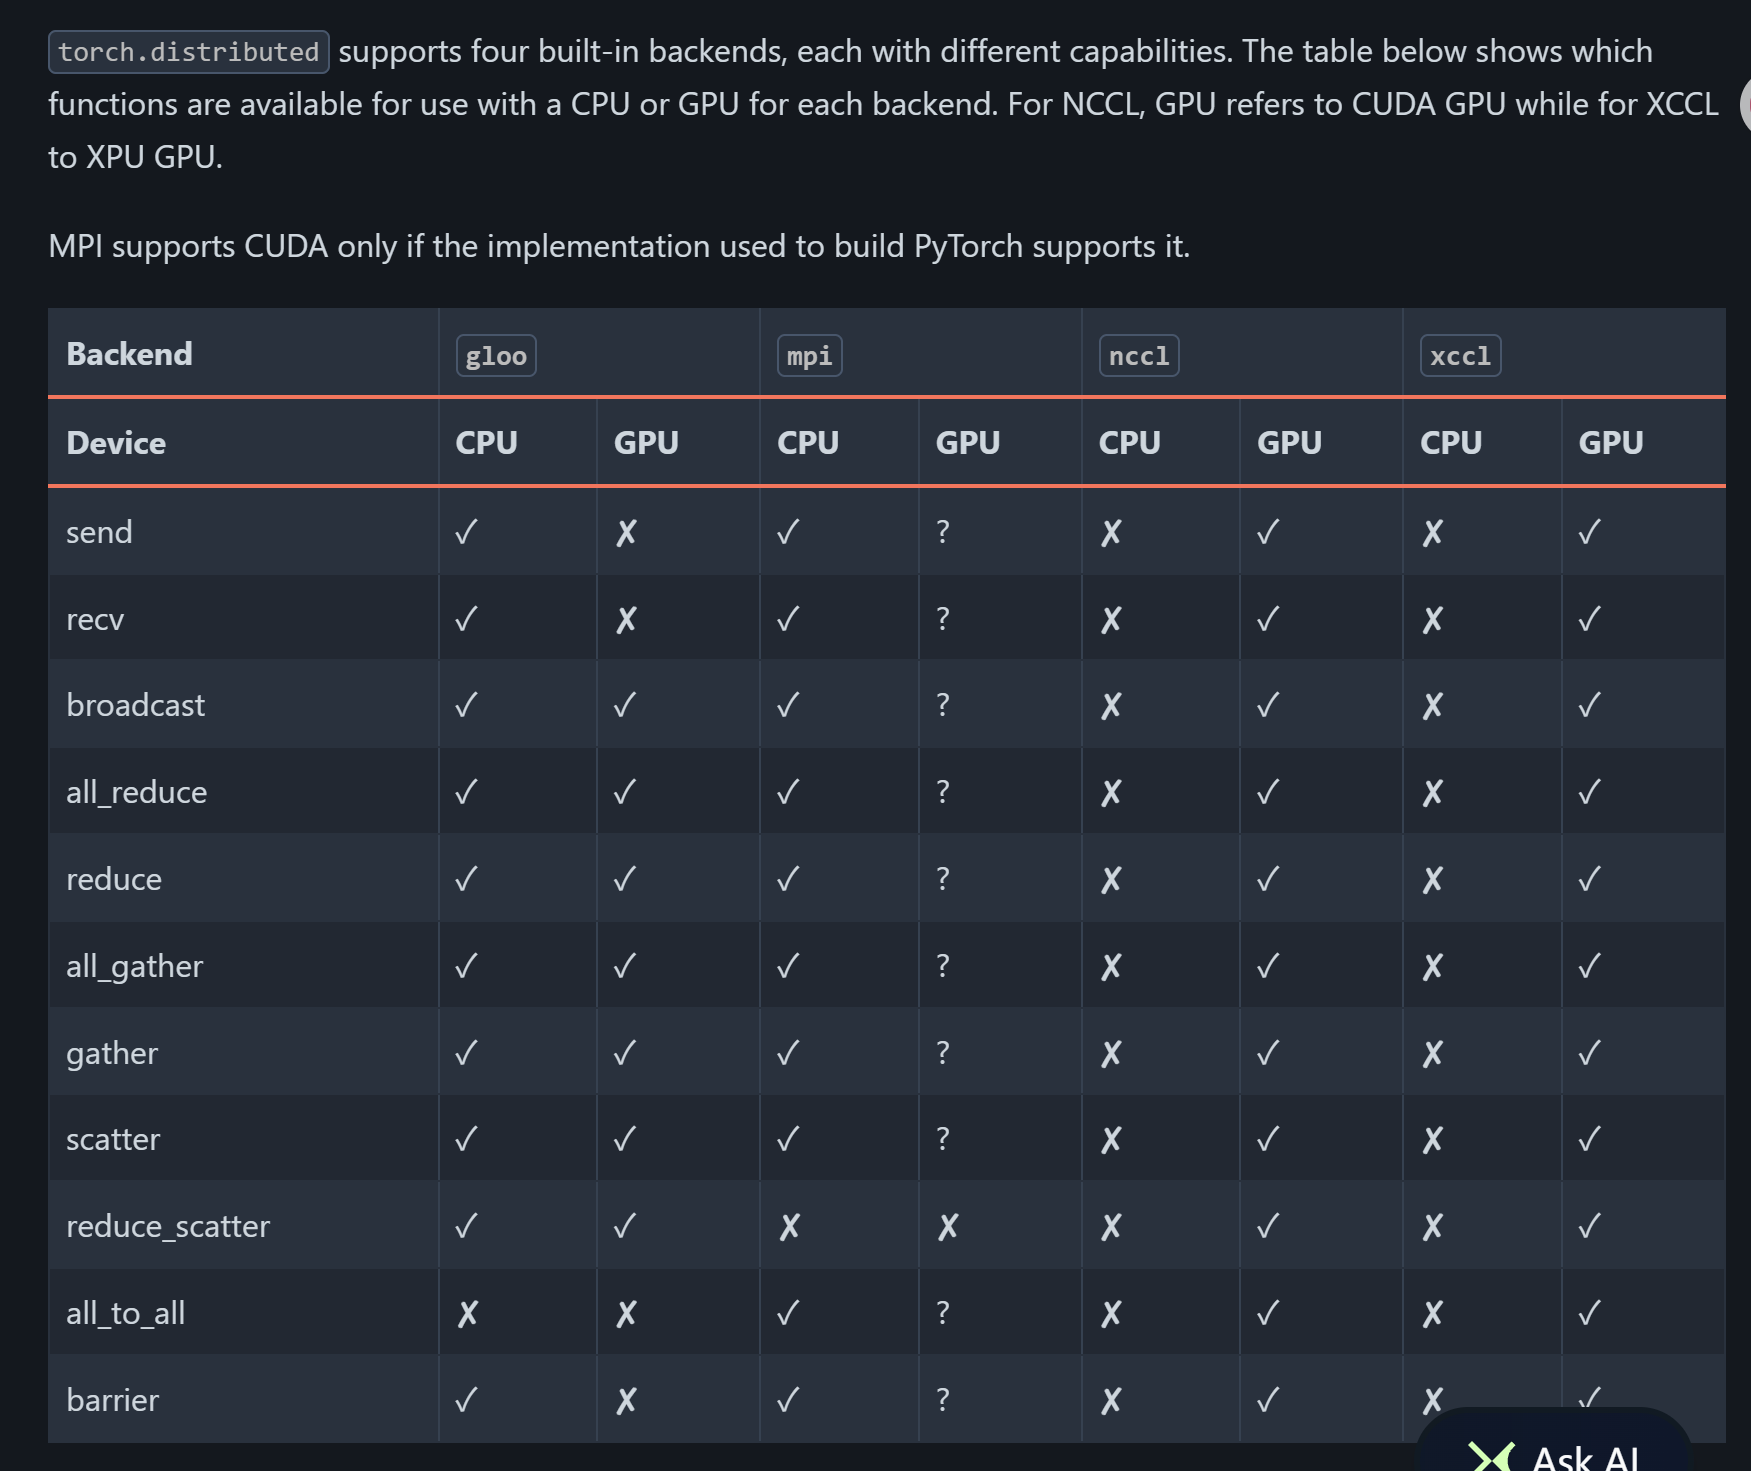
- 进程间通信的后端:communication backend
- NCCL:NVIDIA Collective Communication Libiary
- Gloo Meta开源
- MPI
- 一般nccl用于gpu后端,gloo用于cpu后端,MPI需要从源码重新编译
Point 2 Point Communciation
def run(rank,size):
	torch.cuda.set_device(rank)
	tensor = torch.zeros(1).to(rank)
	if rank ==0 :
		tensor+=1
		#Send the tensor to process 1
		dist.end(tensor=tensor,dst=1)
	else:
		print('init tensor',tensor)
		dist.recv(tensor=tensor,src=0)
	print(f'Rank:{rank},has data{tensor}')
- recv是阻塞式的,不会打印出
Rank:1,has data tensor([0.],device='cuda:1’)的情况
Collective Communciation
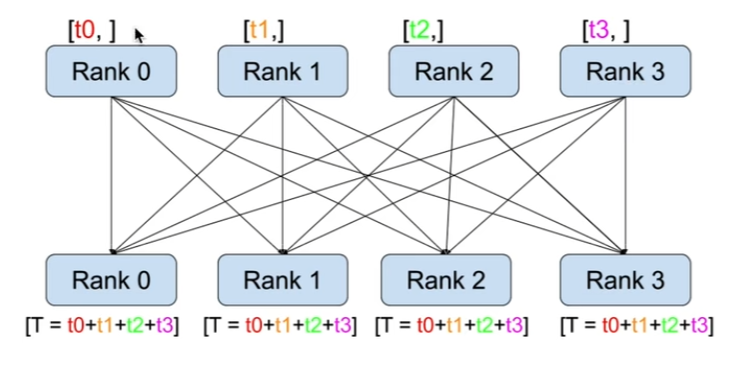
def run(rank,size):
	group = dist.new_group([0,1])
	if rank==0:
		tensor = torch.tensor([1.,2.,3.])
	else:
		tensor = torch.tensor([4.,5.,6.])
	tensor = tensor.to(rank)
	print(f'Rank:{rank},random tensor:{tensor}')
	dist.all_reduce(tensor,op=dist.Reduce0p.SUM,group=group)
	print(f'Rank:{rank},has data:{tensor}')
多进程管理
if __name__ == "__main__":
	size = 2
	processes = []
	mp.set_start_method("spawn")
	for rank in range(size):
		p = mp.Process(taregt=init_process,args=(rank,size,run))
		p.start()
		processes.append(p)
	for p in processes:
		p.join()
	print('finished')
- 通过
mp.set_start_method("spwan")设置进程的启动方式为spawn:
spwan方式为每个子进程创建一个全新的Python解释器进程mp.get_start_method()==>fork(ubuntu system)
- 通过再以恶个循环中对所有进程调用
join()方法,主进程会等待所有子进程执行完成后再继续执行
join()方法确保主进程再所有子进程完成它们的任务之前不会继续执行,确保数据完整性和避免竞争条件的重要机制
