
Verilog 流水线
Whats 流水线
基本思想是吧一个重复的过程分解为若干个子过程。每个子过程都由专门的功能部件来实现,多个处理过程功能上错开,通过各个功能段,这样每个子过程都可以与其他子过程并行进行。
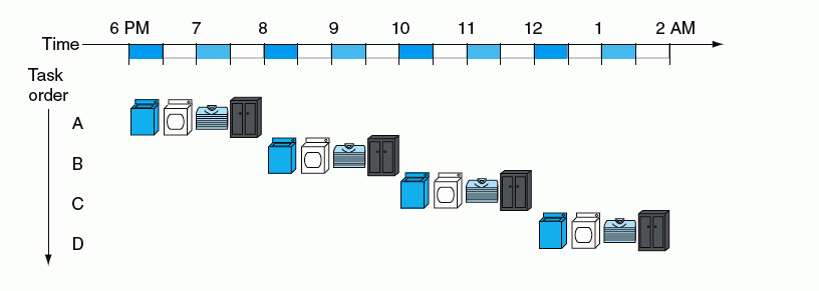
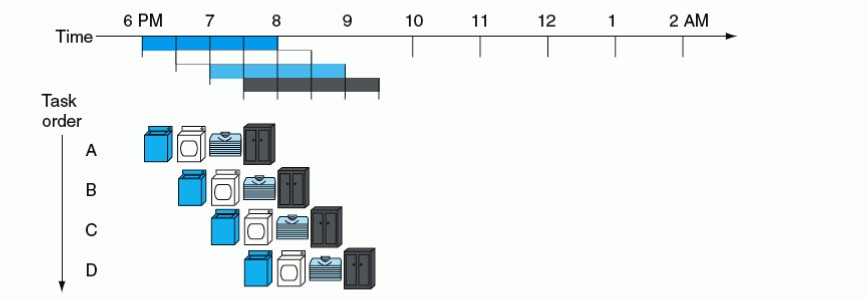
衣服批次越多,节省的时间就越明显。假如有 N 批次衣服,需要的时间为 (4+N) 个半小时。 流水线设计就是将路径系统的分割成一个个数字处理单元,并在处理单元之间插入寄存器来暂存中间阶段的数据。被分割的数据能够按阶段的执行,相互之间没有影响->最后流水线设计能够提高数据的吞吐量,提高数据的处理速度。 但是和完全并行又有一定的区别, 流水线设计,各个处理阶段都需要增加寄存器把偶你中间计算状态,且多质量并行执行,势必会导致功耗增加。
一般乘法器设计
在FPGA中可以直接调用1个高性能的乘法器。位宽较小的时候,一个周期内就可以输出结果,位宽较大时也可以流水输出,能满足要求的前提下,谨慎的用*或者直接调用IP完成乘法运算。
但是乘法器IP有很多缺陷,位宽限制,未知的时序。尤其使用乘号,会为数字设计的不确定性埋下隐患。
很多时候,采用移位相加的形式实现
A = A<<1;//A*2
A = (A<<1)+A;//A*3
A = (A<<3)+(A<<2)+(A<<1)+A;//A*15
有时候数字电路在一个周期内不能够完成多个变量同时相加的操作。数字设计中,最保险的方法时同一时刻只对2个数据进行假发运算,最差设计是同1时刻对4个及以上的数据进行加法运算。 若设计中有同时对4个数据进行假发运算的操作设计,那么此部分设计就会有危险,导致时序不满足
设计原理
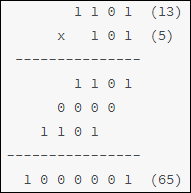
被乘数按照乘数对应的bit进行移位累加,便可完成相乘的过程。 假设每个周期只能完成1次累加,那么1次乘法计算时间最少的时钟数恰好是乘数的位宽,推荐将位宽窄的作乘数!!!
乘法器设计
module mult_low
	#(parameter N=4;
	  parameter M=4)
	  (
	  input clk,
	  input rstn,
	  input data_rdy,
	  input [N-1:0] mult1,
	  input [N-1:0] mult2,

	  output res_rdy,
	  output [N+M-1:0] res
	  );
	  reg [31:0] cnt;
	  wire [31:0] cnt_temp=(cnt==M)?'b0:cnt+1'b1;
	  always @(posedge clk or negedge rstn)begin
		  if(!rstn)begin
			  cnt<='b0;
		  end
		  else if (dta_rdy) begin
			  cnt<=cnt_temp;
		  end
		  else begin
			  cnt<='b0;
		  end
		end
	//multiply
	reg [M-1:0] mult2_shift;
	reg [M+N-1:0] mult1_shift;
	reg [M+N-1:0] mult1_acc;
	always @(posedge clk or negedge rstn)begin
		if(!rstn)begin
			mult2_shit <='b0;
			mult1_shift <= 'b0;
			mult_acc <= 'b0;
		end
		else if (data_rdy && cnt=='b0) begin
			mult1_shift <= {{(N){1'b0}},mult1}<<1;
			mult2_shift <= mult2>>1;
			mult1_acc <= mult2[0]?{{(N){1'b0}},mult1}:'d0;
		end
		else if (cnt!=M)begin
			mult1_shift <= mult1_shit<<1;
			mult2_shift <= mult2_shift>>1;
			mult1_acc <= mult2_shift[0]?mult1_acc+mult1_shift:mult1_acc;
		end
		else begin
			mult2_shift <= 'b0;
			mult1_shift <= 'b0;
			mult1_acc <= 'b0;
		end
	end

	reg [M+N-1:0] res_r;
	reg res_rdy_r;
	always @(posedge clk or negedge rstn)begin
		if(!rstn)begin
			res_r <= 'b0;
			res_rdy_r <= 'b0;
		end
		else if(cnt==M)begin
			res_r <= mult1_acc;
			res_rdy_r <= 1'b1;
		end
		else begin
			res_r <= 'b0;
			res_rdy_r <= 1'b1;
		end
	end

	assign res_rdy = res_rdy_r;
	assign res = res_r;
endmodule
逻辑就是:
- 每个周期被乘数左移
- 乘数右移
- 若乘数的对应位是1,结果累加
流水线乘法器设计
module mult_cell
	#(parameter N=4,
	  parameter M=4)
	  (
	  input clk,
	  input rstn,
	  input en,
	  input [M+N-1:0] mult1,
	  input [M-1:0] mult2,
	  input [M+N-1:0] mult1_acci,

	  output reg [M+N-1:0] mult1_o, //被乘数移位后保存值
	  output reg [M-1:0] mult2_shift, //乘数移位后保存值
	  output reg [N+M-1:0] mult1_acco, //累加结果
	  output reg rdy);

	  always @(posedge clk or negedge rstn)begin
		  if(!rstn)begin
			  rdy <='b0;
			  mult1_o <= 'b0;
			  mult1_acco <='b0;
			  mult2_shift <='n0;
		  end
		  else if(en) begin
			  rdy <=1'b1;
			  mult2_shift <= mult2>>1;
			  mult1_o <= mult1<<1;
			  if(mult2[0])begin
				  mult1_acco <= mult1_acci;
			  end
		  end
		  else begin
			  rdy <= 'b0;
			  mult1_0 <='b0;
			  mult1_acco <= 'b0;
			  mult2_shift <= 'b0;
		  end
		end
endmodule
module mult_man
#(parameter N=4,
parameter M=4)
(
input clk,
input rstn,
input data_rdy,
input [N-1:0] mult1,
input [N-1:0] mult2,
output res_rdy,
output [N+M-1] res
);
wire [N+M-1:0] mult1_t [M-1:0];
wire [M-1:0] mult2_t [M-1:0];
wire [N+M-1:0] mult1_acc_t[M-1:0];
wire [M-1:0] rdy_t;
//第一次例化初始化
mult_cell #(.N(N)m.M(M))
u_mult_step0
(
.clk (clk),
.rstn (rstn),
.en (data_rdy),
.mult1 ({{(M){1'b0},mult1}}),
,mult2 (mult2),
.mult1_acci ({(N+M){1'b0}}),
//output
.mult1_acco (mult1_acc_t[0]),
.mult2_shift (mult2_t[0]),
.mult1_o (mult1_t[0]),
.rdy (rdy_t[0]);
genvar i;
generate
for(i=1;i<=M-1;i=i+1) begin:mult_stepx
mult_cell #(.N(N),.M(M))
u_mult_step
(
.clk (clk),
.rstn (rstn),
.en (rdy_t[i-1]),
.mult1 (mult1_t[i-1]),
.mult2 (mult2_t[i-1]),
.mult1_acci (mult_acc_t[i-1]),
.mult1_acco (mult_acc_t[i]),
.mult1_o (mult1_t[i]),
.mult2_shift (mult2_t[i]),
.rdy (rdy_t[i]));
end
endgenerate
assign res_rdy = tdy_t[M-1];
assign res = mult1_acc_t[M-1];
endmodule